ARC-Bench Agent 项目介绍:从需求树到可验证的代码生成
2026-10-27
本文整理于 2026-10-27。已提交版本的机制以 76612a5 为引用;竞赛通用控制器与五个本地参考应用仍包含未提交工作,下文单列为本地开发快照。本文附有资料摘要与文件哈希,只用于固定本次整理依据,不是完整源码发行包或新的验收记录。
阅读路线:架构 → 需求与上下文 → 生成与工具 → 验证 → 通用任务控制器 → 修复与回滚 → 预算 → 结果。
一、从生成代码到交付应用
多页面 Web 任务同时涉及界面、API、数据模型和状态迁移。注册页面能显示,不代表账户会持久保存;订单按钮能点击,不代表刷新、取消、重新选择和多用户隔离都正确。Agent 的目标是将需求落实为跨模块可运行的行为,并留下可以定位失败的证据。
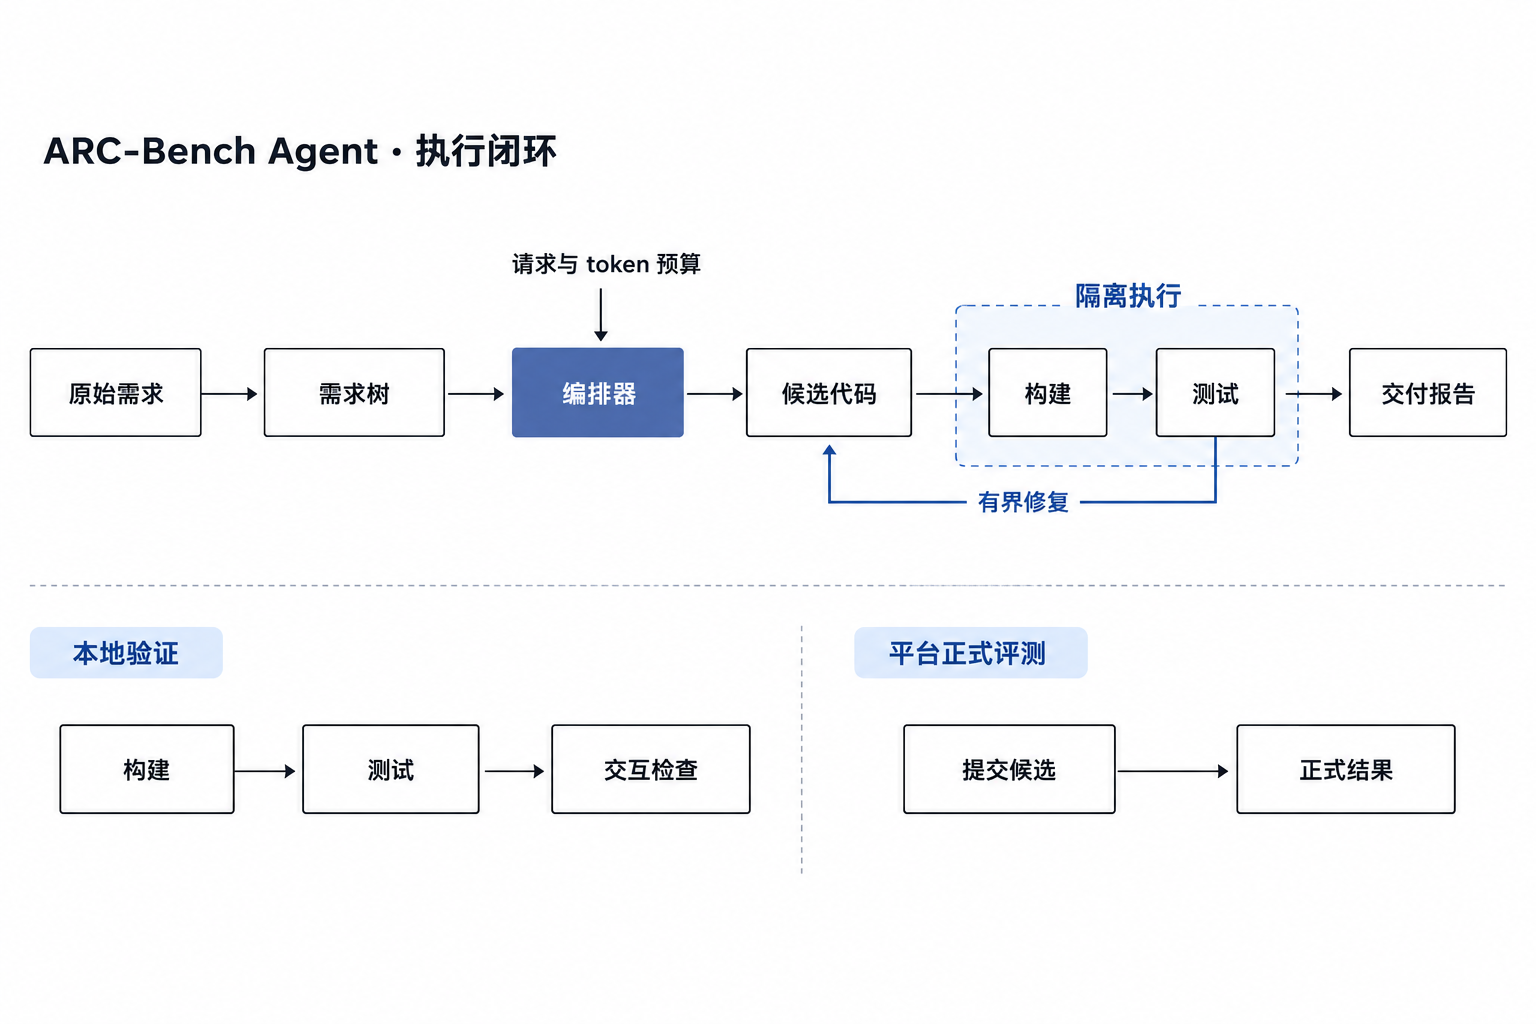
模型负责提出计划、编辑代码和分析反馈;控制程序负责输入身份、可调用工具、预算、验证及停止条件。把这些职责分开后,一次失败可以具体区分为需求遗漏、修改未生效、构建错误、环境初始化失败或业务断言失败,而不是只得到一句“任务未完成”。
二、入口、编排器与验证器
| 模块 | 职责 |
|---|---|
| main.py / Runtime SDK | 接收需求目录与目标工程,使用 Runner 提供的配置,报告设计、实现和测试进度 |
| agent/requirements.py | 读取 YAML 或 Markdown,构造统一需求树并保留来源 |
| agent/orchestrator.py | 按子树组织设计、实现、检查点与整站修复 |
| agent/llm.py / model_transport.py | 管理模型消息、工具循环、流式响应、用量与截断 |
| agent/tools.py | 浏览和编辑项目文件,执行受限构建与测试工具 |
| agent/verify.py / visual_acceptance.py | 收集构建、测试、页面截图、交互和视觉审核结果 |
平台形状的入口为 main.py <requirements-dir> --output-dir <application>。Runner 准备工程,Agent 在目标目录中修改已有文件,不拿一份预先完成的网站覆盖任务。Python 侧负责控制流程,生成的 Web 工程自行声明前后端依赖与脚本。固定版本见运行与模块说明。
三、需求树与上下文组织
Requirement Reader 优先读取 requirements.yaml,也可将 README 或 requirements Markdown 归一化为同一需求树。树保留父子层级,使“订单管理”的总体约束可以随“创建订单”“取消订单”等子模块一起进入实现上下文。原始需求保持不变,不能通过缩减需求来消除失败。
有参考图时,需求图片作为视觉输入交给规划或实现模型;任务还需要一份视觉验收清单,描述参考图对应页面、视口、裁剪和交互。是否强制要求某张图,要服从原始文字中 Required 与 Optional 的作用域。本地通用化读取器进一步修复了多行可选引用的范围,避免把可选设计参考变成额外硬性验收条件。
大任务不能只按页面名称切块。本地 competition_context.py 将原子需求组织为带来源的工作项,同时带入祖先约束、依赖、数据生命周期、测试与共享 helper;依赖展开后检查未知节点和环。实现顺序因此可以先建立账户、数据和公共接口,再落实依赖它们的交互。
源码或需求太长时,模型可以分页读取精确原文。审核引用必须同时对应原始义务与当前源码片段;文件改变后旧哈希和旧结论失效。只读到一部分、引用陈旧文件或无关片段,不足以把整个模块标记为完成。这套通用化代码属于本地开发快照。
四、模型工具循环怎样推进实现
一次实现并非“给模型需求,接收整份代码”。模型先定位文件、读取相关实现,再通过工具修改,随后获取命令退出码与检查输出,决定下一步。局部文本替换要求唯一匹配,避免模糊替换悄悄改错位置;模型输出截断会被明确记录,不能把半段工具参数当成完整操作执行。
消息前缀保持系统指令、需求子树和实施计划一致,后续连续追加完整工具轮次,有利于服务方复用缓存。上下文超过 240,000 字符、检查反馈变化等条件触发有界压缩;图像不在每轮重复发送。日志按响应实际记录缓存命中与未命中 token,缺字段时保留 unavailable,而不是从输入量估算缓存收益。
控制器还需要识别停滞。连续三轮完全相同的失败工具调用会在提醒后停止;连续没有文件改动也有提醒和上限。实现阶段从第 16 轮起定期运行现有构建和测试脚本,把具体错误送回模型,而不是一直编辑到预算耗尽才发现整个工程无法构建。对应实现见工具循环与上下文管理。
五、验证分层,而不是一个通过按钮
| 验证层 | 回答的问题 | 不能替代什么 |
|---|---|---|
| 构建与启动 | 依赖、语法、导入、脚本和服务能否运行 | 业务行为是否满足需求 |
| 源码需求审核 | 原始义务在具体生产代码中是否有实现证据 | 真实浏览器和持久化行为 |
| 本地公开案例 | 指定控件、API、状态与交互断言是否通过 | 未公开或不同环境的正式平台验收 |
| 视觉与交互 | 页面、视口、截图和交互是否匹配参考 | 所有业务路径或像素级普遍一致 |
| 平台 Stage 3 | 该次上传版本在平台测试中的正式结果 | 后续修改版本和其他任务的成绩 |
对订票 Demo,公开案例正文及共享交互 helper 进入模块上下文,精确标签、控件角色和断言保持原样。由于逐例面板没有完整 spec 的 imports 与文件内 helper,本地补齐 jsdom 适配器的回归要与原始平台 Playwright 测试分别记录。额外浏览器探针用来检查真实 App 与后端,不能被自编测试转绿替代。
源码审核要求每个缺口引用原始要求和已经读取的生产代码。如果审核发现业务缺陷,后续修复必须重新通过源码审核;只扩写测试或让构建变绿不会清除这个缺陷。同一运行内,只有完整审核输入不变时才可复用结论,避免无意义的重复审核。
模块状态也与证据绑定。设计完成、实现完成、本地测试通过和正式验收是不同字段;父节点不能因部分子节点通过就变绿。新的测试证据未知时,旧测试状态要清除;ROOT 单独反映整套验证的退出结果。因此某些需求的本地案例可以通过,而整站仍因 runner 错误失败。见阶段编排与验证结果处理。
六、通用化:把任务和运行环境变成明确契约
本节描述 2026-10-27 的本地开发快照。通用控制器通过显式竞赛入口接入,旧订票路线独立保留。它的通用性来自来源、依赖与验证协议,不来自为六个任务各写一套名称分支;真实跨任务自动生成成功率仍未得到验证。
不可变任务包
task_bundle.py 固定需求、测试及 helper 的原始字节与 SHA-256,保存任务、模块、场景和文件来源。案例身份还包含 project、文件与完整标题路径,防止两个同名测试被错误合并。输入变化、动态导入无法解析、缺失依赖或数量不一致会阻止继续,而不是让模型猜测缺失内容。
六任务原始目录包含 337 个原子需求,实际收集 514 个公开案例,平台标称 518 个。收集使用真实 Node/Playwright;因为 --list 也会加载 JavaScript,收集本身同样放进容器。没有把“能收集”当作“测试通过”。
数据初始化、时钟与隔离世界
一个测试可能需要空账户,另一个需要历史订单,还有任务要求每个案例独立运行。verification_world.py 显式定义 normal/history 等环境,绑定 origin、storage、run ID、seed、业务时钟和健康检查。SEED 数据可在新环境初始化;本应由用户操作生成的 CREATED 数据不能预置来迎合断言。
普通服务重启应保留已创建数据,新的验证 run 则重建干净环境。种子哈希只证明输入没有变,SQL/HTTP 初始化观察还要验证应用实际消费了它;时钟合同同样需要浏览器与服务端行为一致。当前本地 Node Date preload 不自动覆盖所有语言和所有日期路径,正式 Runner 是否提供等价环境仍待验证。
应用与测试各自隔离
生成应用和验证器分别运行在非 root、只读容器中,通过内部网络连接,不暴露主机端口。应用拿不到测试源码、验证报告或 Docker socket;原始测试只读挂载到验证器。报告从受控通道导出,清理和输入哈希复核完成后才形成最终结果。
执行依赖预先准备的本地缓存。验证使用严格禁网 npm ci,核对 manifest 与 lockfile,缓存缺失明确失败。SQLite 等原生依赖还需要单独验证编译和加载:包能安装,并不意味着后端能启动。源代码、依赖缓存、镜像和运行配置都进入指纹,旧镜像不能冒充新源码的验收环境。
七、修复、候选比较与回滚
通用控制器执行“预检与收集 → 全局设计 → 按依赖实现 → 完整验证 → 分类修复”。失败按输入、基础设施、构建运行、业务行为、模型停止等类别处理。原始测试缺失或环境未初始化,不能交给模型不断修改业务代码;共同失败组则连同依赖与调用方进入有限修复。
候选比较保留新增通过、丢失通过、未执行和阻塞的案例集合,要求案例与环境可比。它不只看通过数量:修复一个页面却破坏另一个流程,要能恢复此前较好的源码。恢复后必须使用新 run ID、新环境完整重测;旧报告和重复 run ID 不能解除 RESTORED_CANDIDATE_UNVERIFIED。
一个离线回归专门构造了这种情况:初始候选 1/2 通过,修复破坏 seed,导致下一轮没有可信行为报告;控制器恢复原候选,再在新环境重测,仍得到 1/2,然后因无进展停止。这个实验验证了回滚机制,最终状态仍为 DELIVERABLE_INCOMPLETE,并没有把恢复成功写成业务全过。
另一次兼容性修复保留对外的 BUILD_RUNTIME 分类,将 WORLD_OBSERVATION 等具体失败阶段作为附加信息,避免下游只认识旧分类时错误处理初始化失败。这类状态契约让修复策略与运行基础设施之间保持明确边界。
后续还修复了初始化应用错误被误判为基础设施故障的问题。子进程日志可能被截断,单靠文本阶段不能可靠分类;控制器增加专用退出状态与严格类型化的失败尾记录,将明确的应用初始化错误归为 WORLD_INITIALIZATION,允许进入应用修复。OOM、信号终止和协议错误仍保持基础设施阻断,不让模型反复改业务代码。
八、预算与交付收尾
已提交版本的配置模块默认限制单次运行 250 次模型请求、累计 8,000,000 个输入加输出 token,每次输出上限 12,000;这些默认值不等于平台入口的实际覆盖值。请求前检查累计量,响应后记录实际 usage;一条请求的实际用量无法预先精确确定,所以可能越过总阈值。接近上限时预留额度用于收尾,停止新功能生成,继续本地验证并保存已有文件。
上述固定提交的 main.py 入口覆盖为 10,000,000 token / 250 次请求,并只接受 deepseek-flash;本地未提交的开发入口已移除这些覆盖和白名单,保留 Runner 提供的模型、预算和时限。SSE 需要收齐结束标记、工具参数和最终用量后才能执行,HTTP 200 或半段内容不算完整响应。来源见默认预算与历史入口区别。
本地竞赛路线进一步加入持久资金账本,将任务输入、Agent 代码和费率证据绑定起来,按设计、实现、修复、审核阶段预留请求成本,再按观察到的 usage 结算。重启不能重置额度;上次遗留未结算请求会作为未知费用阻止继续。离线替身价格只用于机制自测,不能授权真实模型请求。
资金守卫也经历过一次边界修复:启动时有效的报价,可能在后续请求前过期或被替换。现在每次预留都在持久事务中重新核对代码、任务输入、报价字节、来源快照、有效期、路由及输出上界;失效后持久停止。已经发出的请求仍按完整返回用量结算,下一次请求再阻断,不能丢弃已发生的费用。相关反例先复现失败,修复后 45 项针对性检查通过;它们均是离线替身验证。
交付报告分别说明本地验证、候选可启动状态与待执行正式验收。一个可构建、可启动但仍有本地断言失败的候选,在既定路线允许时可以交给平台继续验收,但必须保留失败记录;“可交付候选”和“已正式通过”始终是两个结果。
九、正式结果、本地机制与参考应用
订票 Demo:一次正式 30/30
仓库归档的 Railway Ticket Booking Demo 在 2026-10-14 正式 Stage 3 取得 30/30。使用 Flash,记录 209 次完整响应、8,505,443 个 token;本地验证中有失败,最终恢复到可交付候选后通过正式评测。它支持该任务该冻结版本的结论,不自动扩展到后续通用控制器。服务端上传包哈希未公开,本地包身份与服务端身份不作未经证明的等同。见冻结证据。
五个本地参考应用:验证任务行为与环境
以下是手工本地参考实现在原始公开测试下的结果。它们帮助验证业务需求、初始化与测试环境,不是被测 Agent 从 Blank 自动生成的成绩。Ctrip 尚未执行,四条公开数量差额继续保留。
| 任务 | 本地公开案例 | 公开 / 标称 | 证据类别 |
|---|---|---|---|
| Keep | 33/33 通过 | 33/33 | 手工参考实现 |
| BookStack | 35/35 通过 | 35/36 | 数量差额仍在 |
| Stack Overflow | 66/66 通过 | 66/68 | 数量差额仍在 |
| PrestaShop | 86/86 通过 | 86/86 | 手工参考实现 |
| 12306 | 142/142 通过 | 142/142 | 手工参考实现 |
| Ctrip | 未执行 | 152/153 | 数量差额仍在 |
五个已执行任务合计 362 个现有公开案例通过,但 BookStack 和 Stack Overflow 的整体 verifier 仍保留目录数量不一致,不能说五个任务都通过完整标称验收。六任务真实模型生成、正式平台验收和正式 Runner 环境等价性均未完成验证。
12306 的一个排错过程
12306 参考实现将账户、乘车人、车次、席别、锁座、订单与支付模拟接入 SQLite。服务端重新检查账户归属、席别、余量和价格,预览不建单,确认才创建订单;普通刷新或重启不重置锁座期限。它展示了多模块任务里真实状态联动的复杂度。
首次完整公测为 112/142。失败快照显示 HTTP origin 下 crypto.randomUUID 不可用,导致页面交互中断;修复为该环境支持的随机字节接口,并修正独立的控件可访问名称问题。随后达到 141/142,剩余失败来自日期切换时先卸载旧列表造成的读取竞争;改为新结果就绪后替换,并在加载期间禁用操作,达到 142/142。补齐预订日期的 Asia/Shanghai 自然日处理后,最终源码再次完整通过 142/142,零跳过、零重试。
这条记录保留启动失败、中断尝试、部分通过与最终运行。它是参考应用的诊断案例,不是 Agent 自动修复率,也不是对历史订票 Demo 平台失败的追溯归因。
十、当前交付与未完成部分
已具备的主线是需求树驱动的模型工具循环、阶段进度、构建与源码审核、公开交互回归、视觉验证、预算收尾和历史单任务正式证据。本地通用化又补入不可变任务包、依赖工作项、隔离环境、严格验证器、候选比较与持久资金账本。
下一步需要把通用化源码与环境冻结为可复查候选,再验证真实模型从初始工程完成多个任务的完整链路。参考应用通过、脚本模型自测通过与真实自动生成成功回答的是不同问题;后续报告将分别给出生成成功率、修复轮次、费用、失败分母和正式成绩。当前公开 514 与标称 518 的差额,以及线上 Runner 初始化、依赖和计费合同,仍是不能省略的未确认项。