从零构建 EvoRec:一个推荐算法项目的持续实践记录
2026-09-15 · 持续更新
记录从选题、方案设计、算法实验到系统展示的完整过程。
当前阶段:R05 冷样本加权排序已完成,协同过滤、内容检索、门控策略和排序优化形成完整链路,正在准备在线业务接入。
这篇文章随项目一起更新,记录问题如何拆解、方案为什么这样选择、实现遇到的困难,以及实验最终说明了什么。当前已完成从基线到冷启动优化的五轮离线实验,线上业务与前端仍在接入中。
一、为什么开始这个项目
- 我的技术背景:以 C++ 为主,开始学习 Python 与推荐算法。
- 希望通过项目掌握哪些能力:问题建模、论文复现、实验设计和工程实现。
- 为什么选择“动态商品库推荐”作为研究场景。
- 希望最终交付什么,以及目前尚不确定的地方。
这一节重点讲清楚:项目从哪个具体问题出发。
二、EvoRec 要解决什么问题
- 一个具体场景:新商品入库后,怎样参与推荐?
- 用户兴趣变化、商品冷启动和计算预算之间的关系。
- 产品的主要使用者与操作流程。
- 最终展示内容:推荐体验、用户反馈、新品发布、策略对比和效果看板。
- 成功标准:功能完成、实验可信、结果可追溯。
三、从想法到技术方案
- 如何编写 PRD,明确功能范围与验收条件。
- 如何把产品需求拆成算法、数据、服务和展示模块。
- 为什么选择 Python/PyTorch 作为算法主体。
- Faiss、PostgreSQL、FastAPI 和 React 分别解决什么问题。
- C++ 计划用在哪里,什么情况下值得投入。
- 哪些方案经过比较后暂时没有采用,原因是什么。
四、第一阶段:建立工程框架
- 工程目录如何组织,各模块的职责是什么。
- 为什么先定义接口和数据契约。
- 为什么区分“进程存活”和“推荐业务就绪”。
- 商品导入、反馈事件和会话版本有哪些约束。
- 第一批检查覆盖了什么,以及没有覆盖什么。
当前实际进展
- 已完成项目框架、架构和接口等设计文档。
- 已建立 FastAPI 最小骨架与共享输入契约。
- 首轮 23 项自动检查通过;随着请求绑定、过滤、超时和保存失败边界补齐,当前累计 55 项通过。
- 模型和存储使用测试替身,公开推荐接口与前端尚未接入。
这些检查证明当前契约与应用层边界符合设计,不能据此认定推荐效果、数据库事务、模型发布安全性或真实吞吐已经成立。后续适配器必须继续遵守模型、编码器、映射和索引组成的 bundle 版本绑定,以及请求 ID、会话 ID、epoch、历史版本、bundle ID 和下架版本组成的 RequestBinding。
五、第二阶段:准备数据与建立基线
- 数据从哪里来,包含哪些字段。
- 如何清洗交互、统一商品 ID 和处理缺失数据。
- 如何划分训练、验证和测试数据。
- 怎样避免未来信息进入训练或评估。
- “模型冷物品”和“刚刚发布的新品”有什么区别。
- 首次跑通的基线、使用的设备、资源消耗与结果。
R01 已完成。 从官方 Video_Games 交互文件读取前 50,000 条,得到 20,375 个用户和 18,508 件商品;在 2,291 个测试正反馈上,热门推荐 NDCG@10 为 0.007388,ItemCF 为 0.004636。共有 79 项检查通过,9,852 条逐请求结果完成独立核对。前缀样本中 1,101 个测试目标在请求时尚未被观察到,保留在主指标分母中。
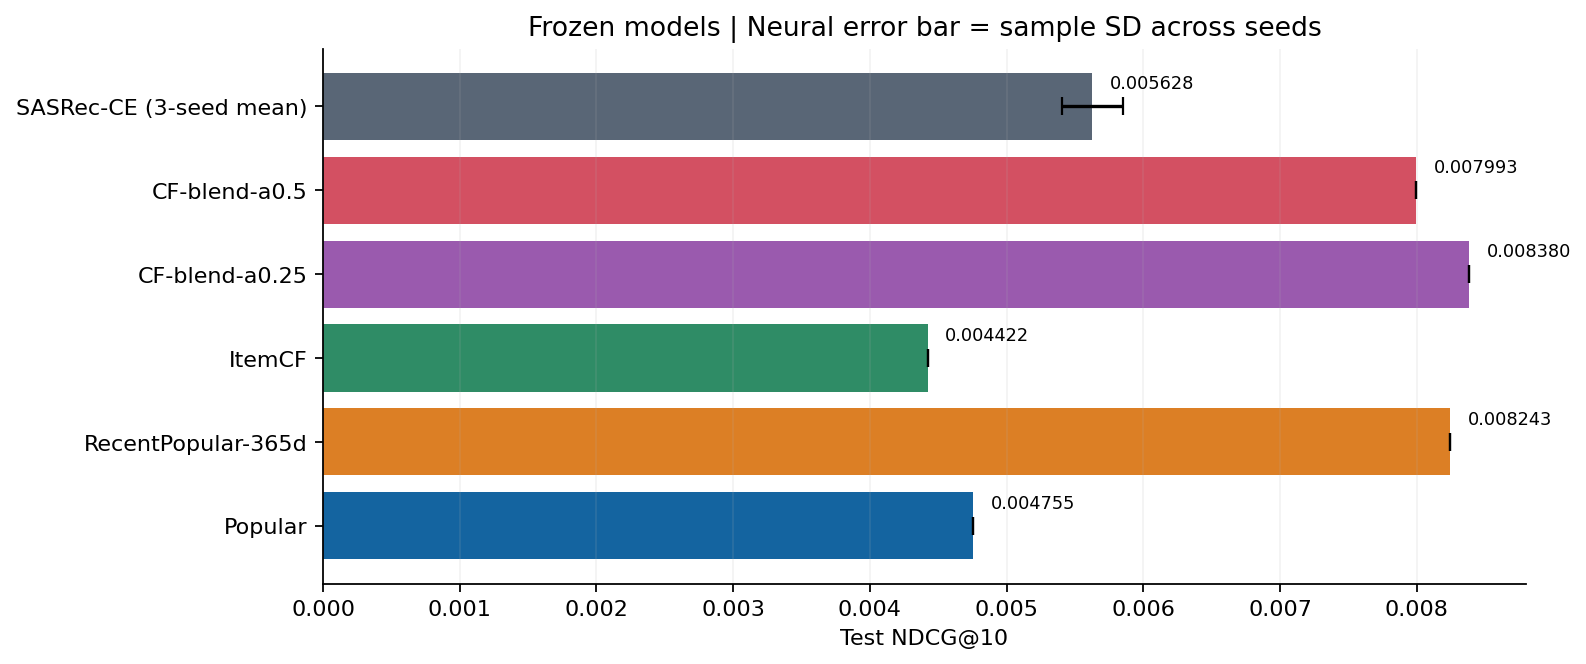
R02 已完成。 完整扫描 4,555,500 条交互,按固定用户哈希保留约二十分之一用户的全部记录,得到 226,172 条交互和 137,103 个用户。GPU 自注意力序列模型完成 4 次训练、39 个 epoch 和三个种子运行;测试 NDCG@10 为热门 0.004755、时间衰减协同融合 0.008380、序列模型均值 0.005628 ± 0.000222。序列模型超过历史热门,但没有超过更强的时间衰减基线。
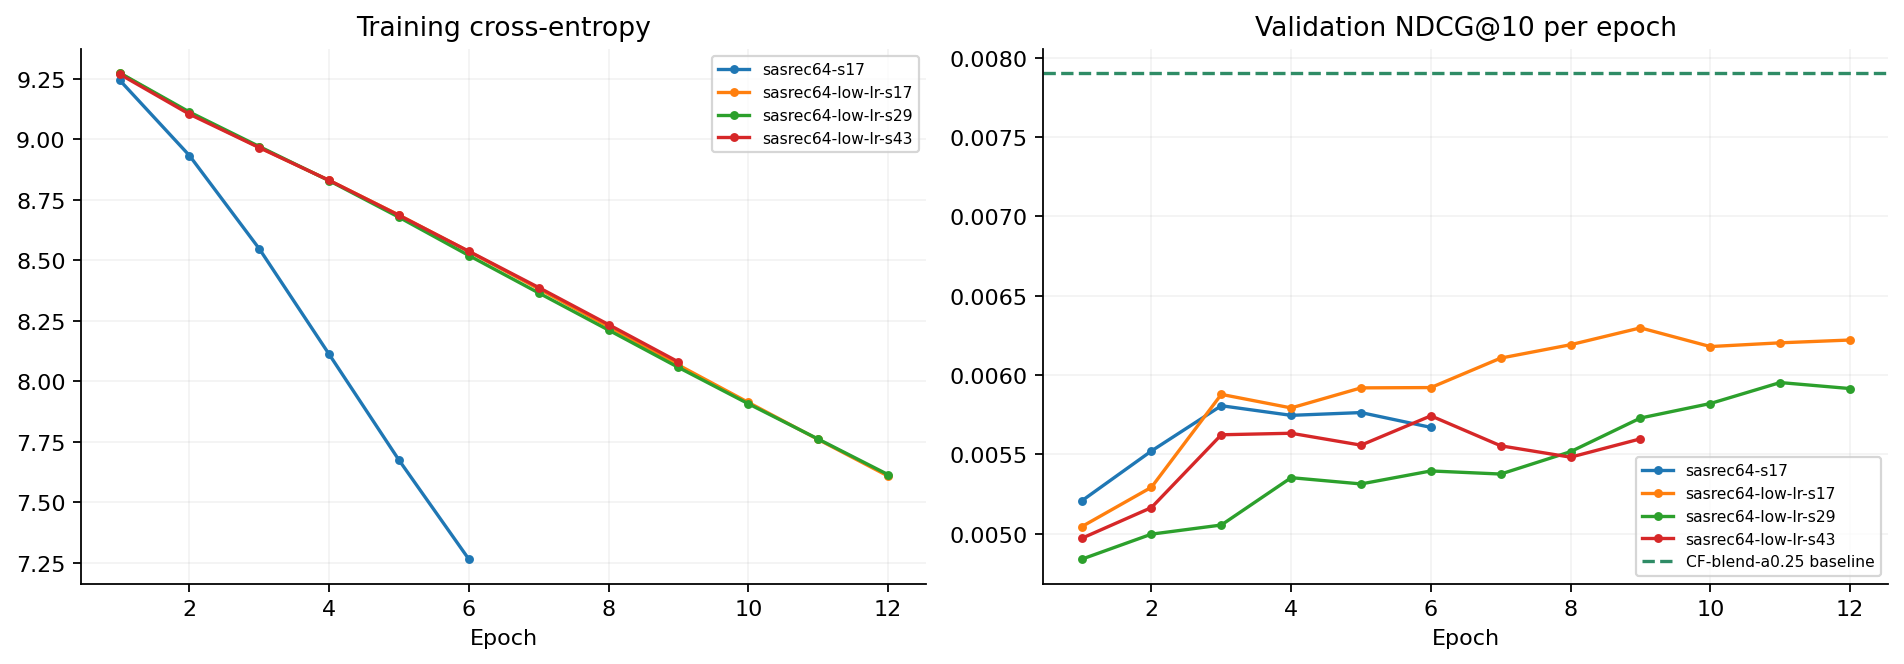
本轮还发现 6,874 个模型冷且可用目标全部未命中。没有商品表示入口时,继续增加 Transformer 训练轮数无法让新商品进入词表;下一步先补内容候选路径,并登记新的评价窗口。
R03 已完成。 引入内容双塔架构,使用商品标题、品牌和类别进行语义编码。完成 48 个 epoch 训练,构建协同过滤与内容检索的混合召回策略。内容融合改善整体排序性能,但冷商品命中率仍低于预期。
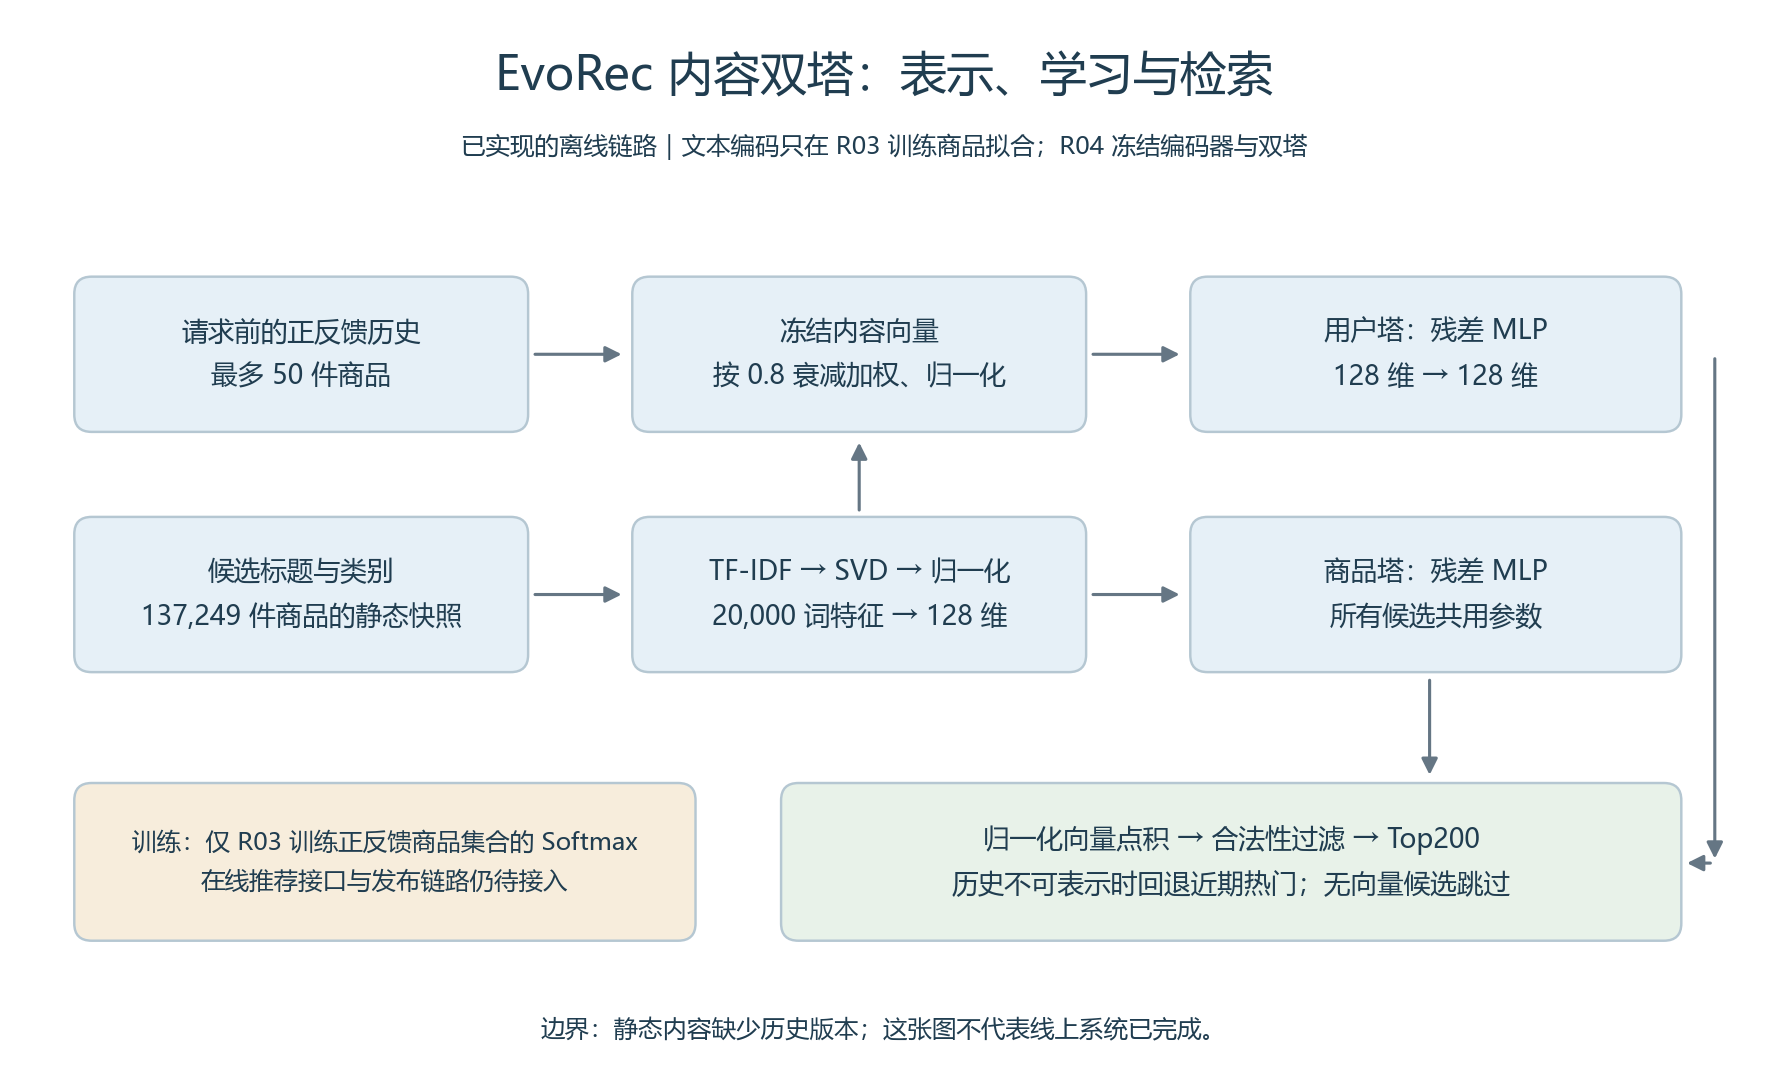
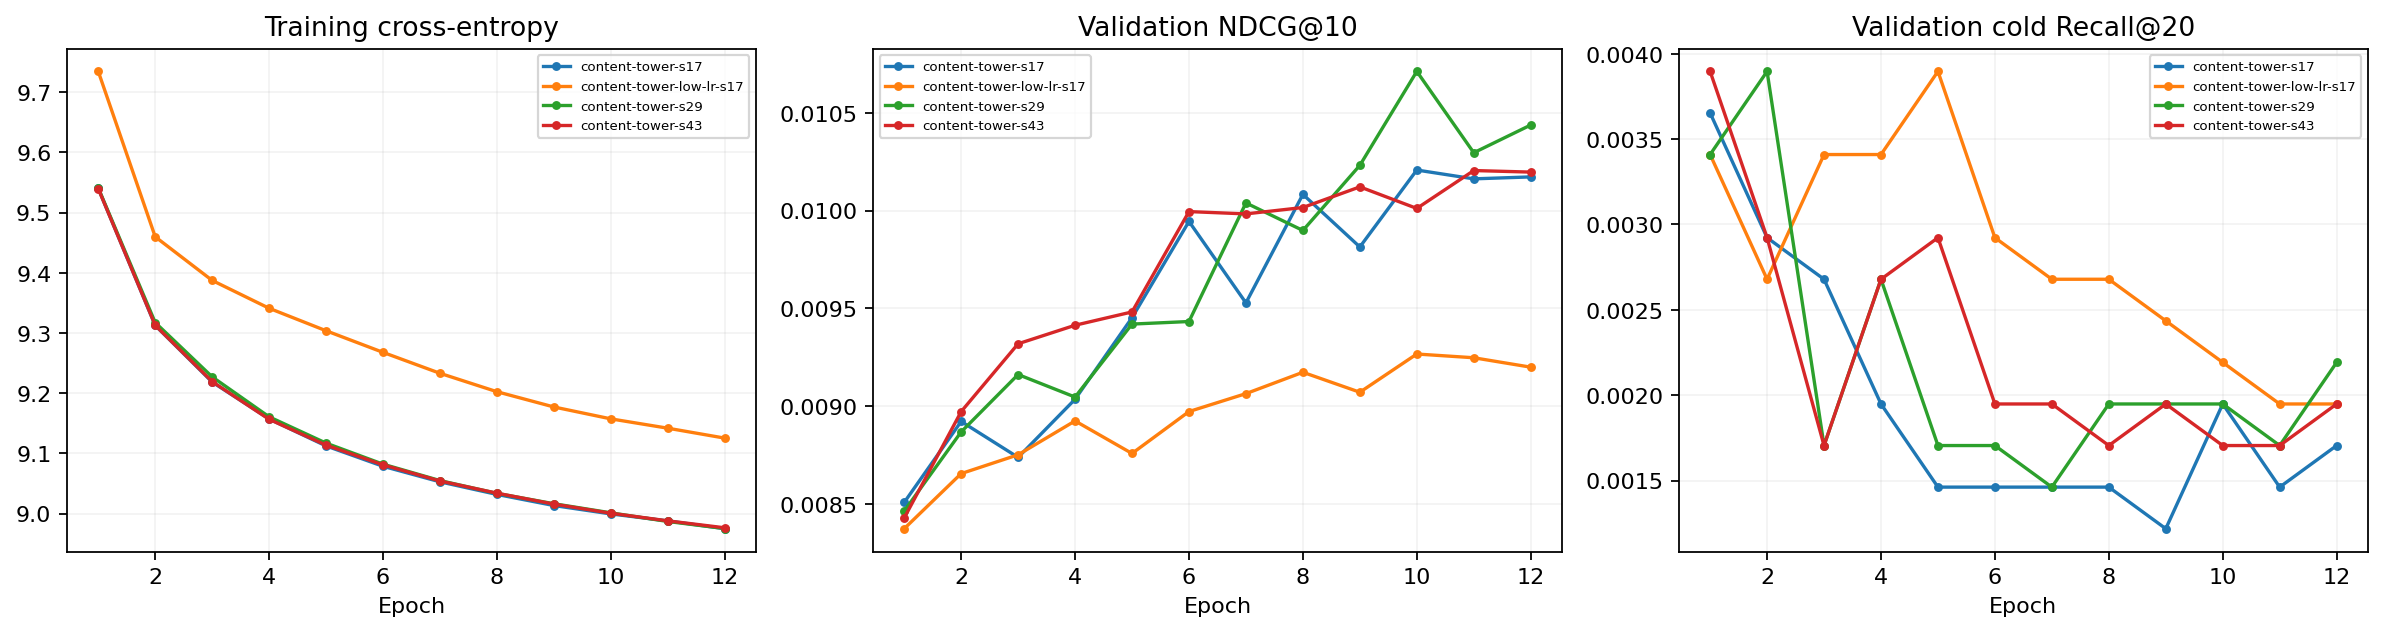
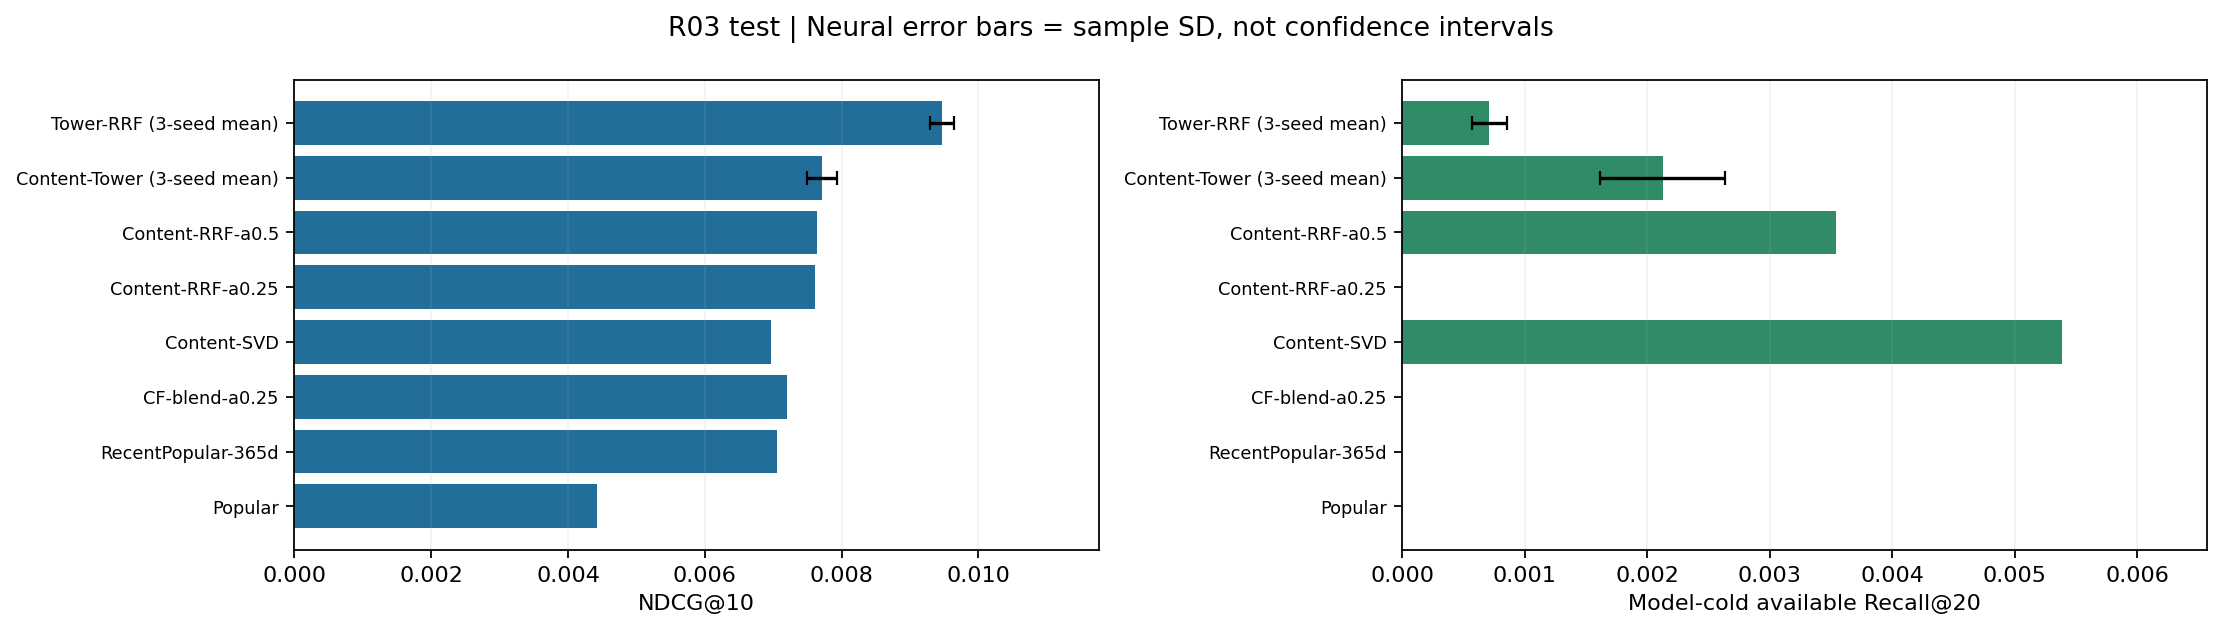
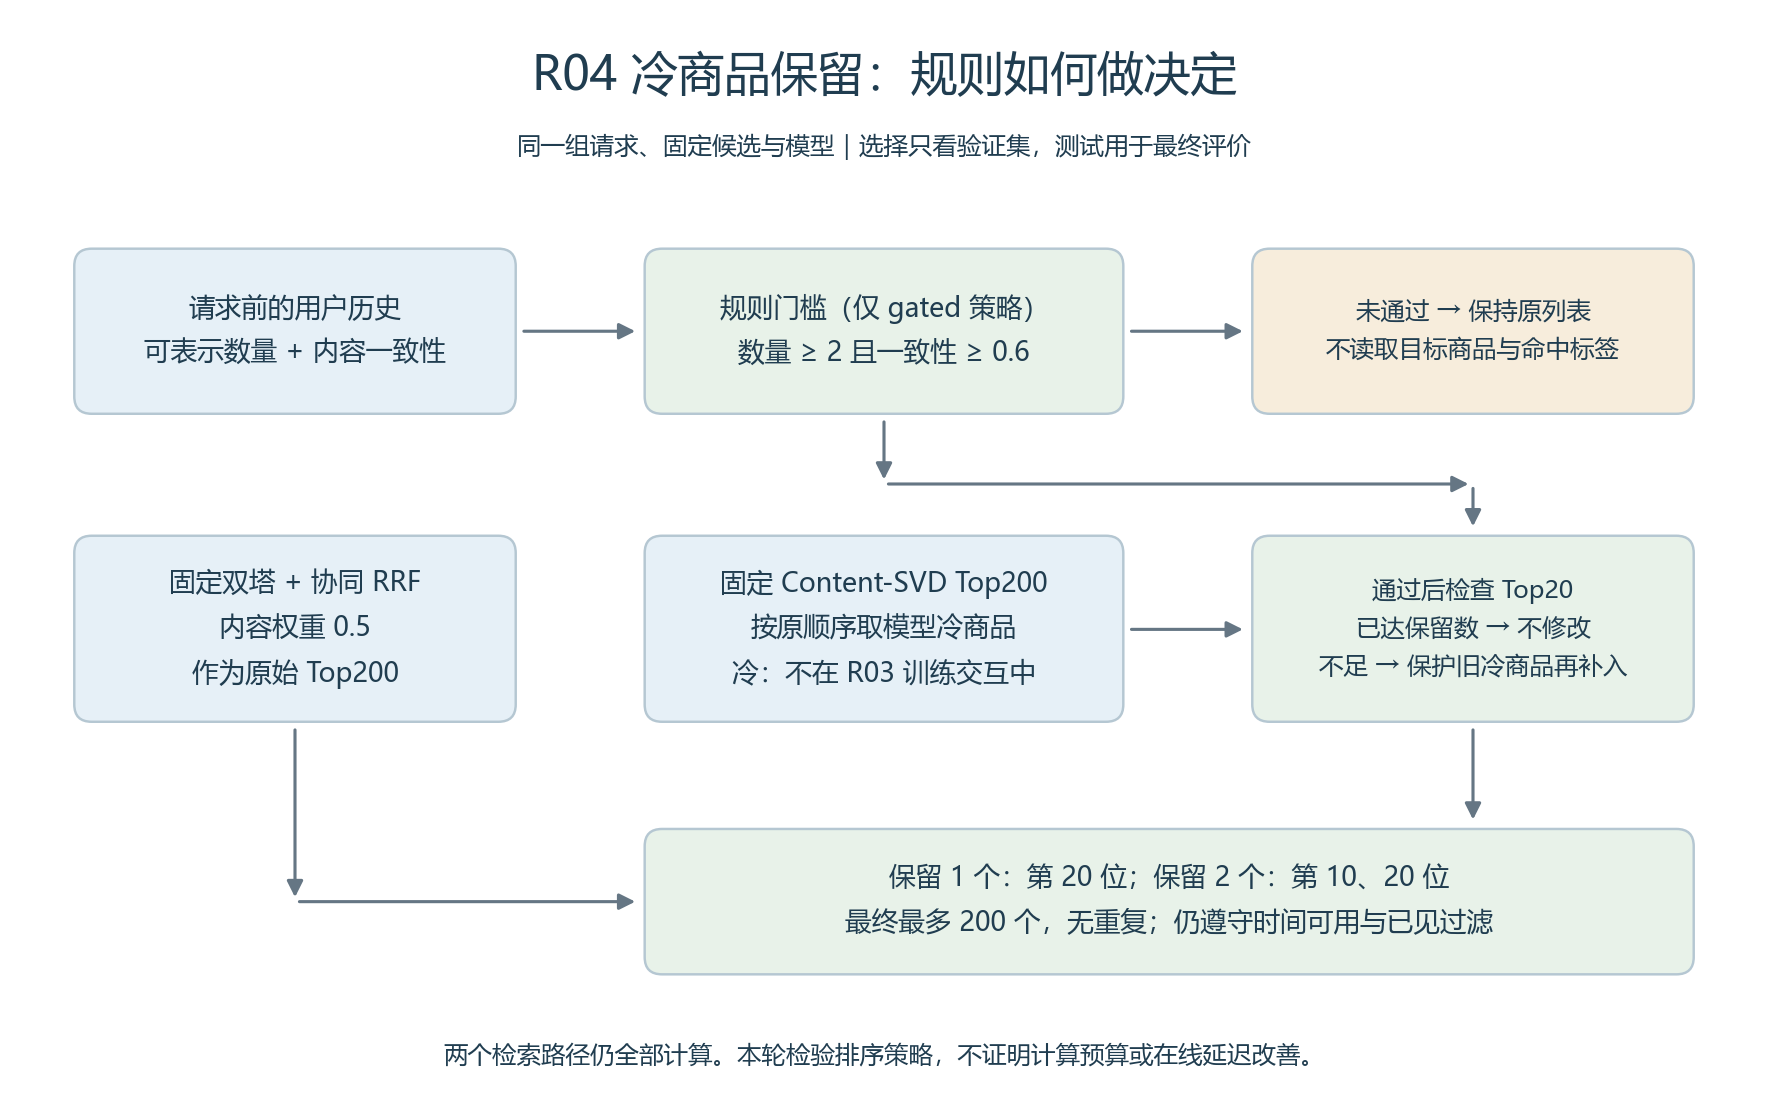
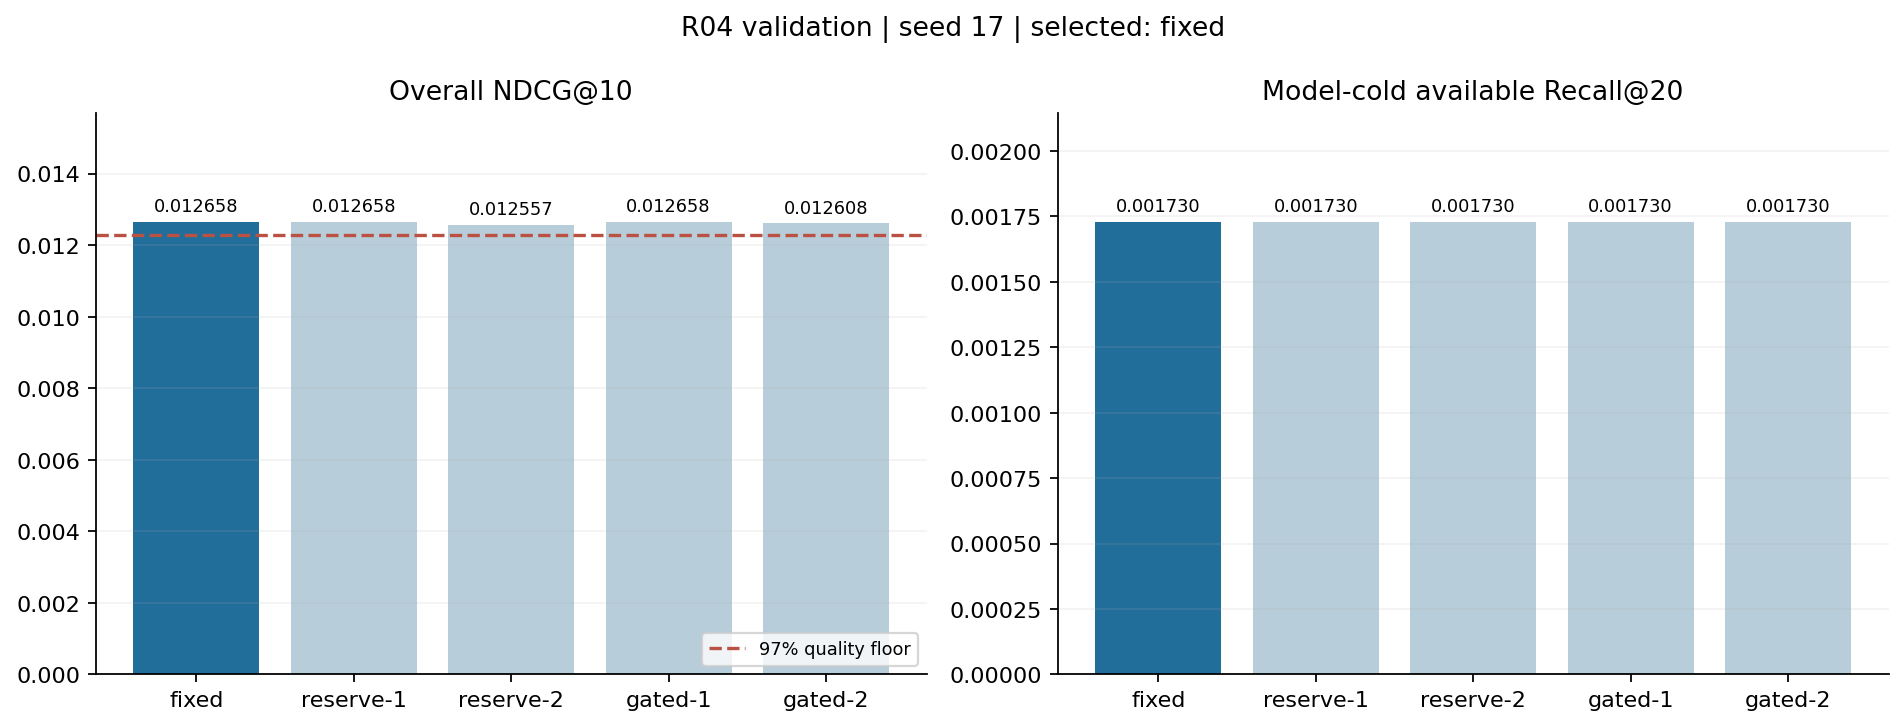
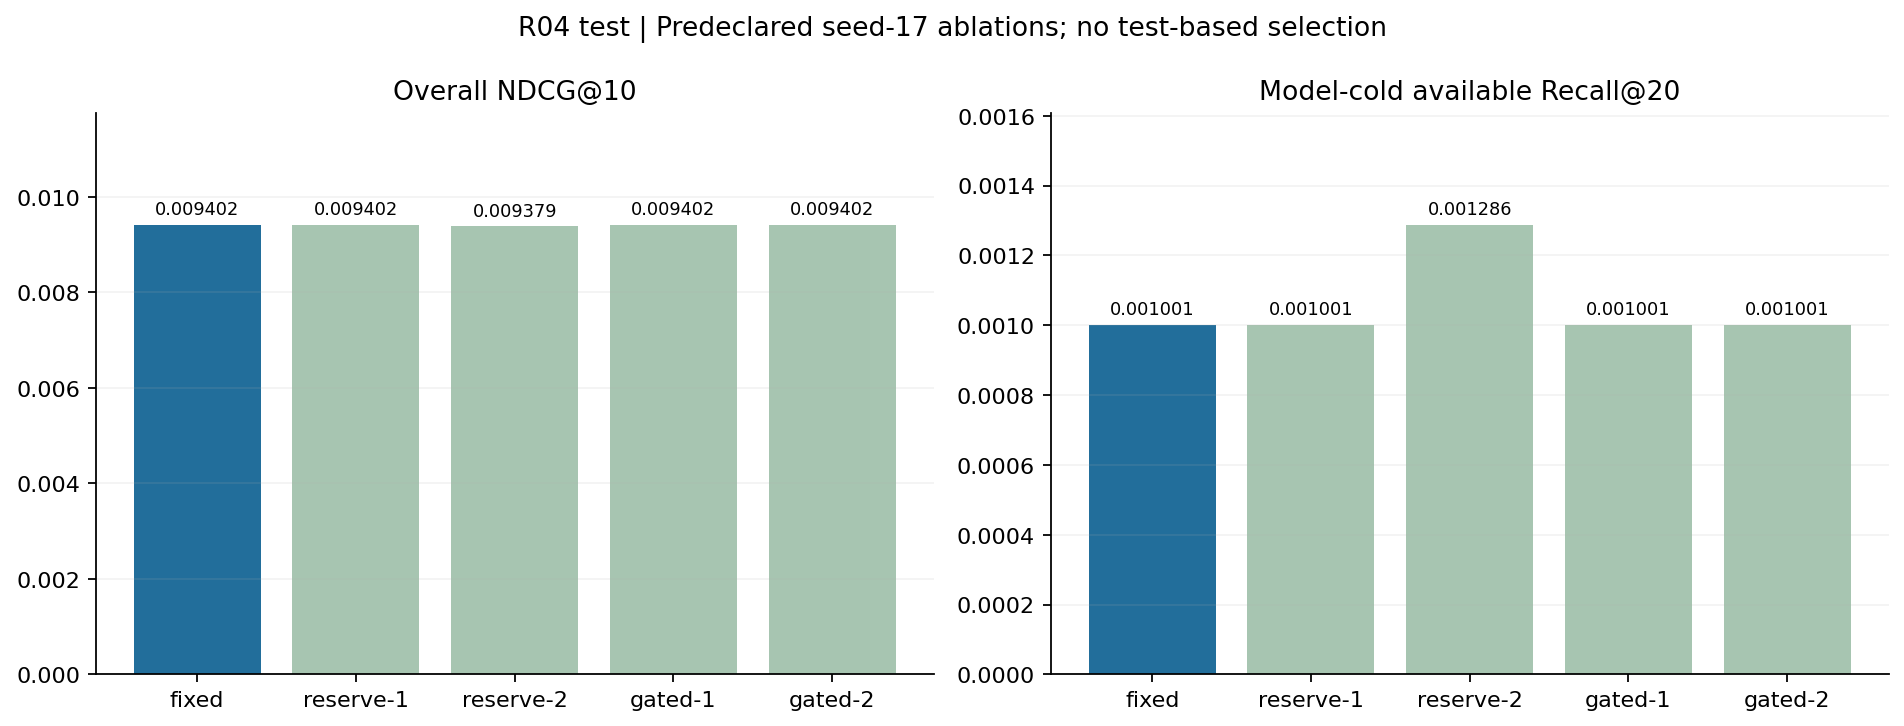
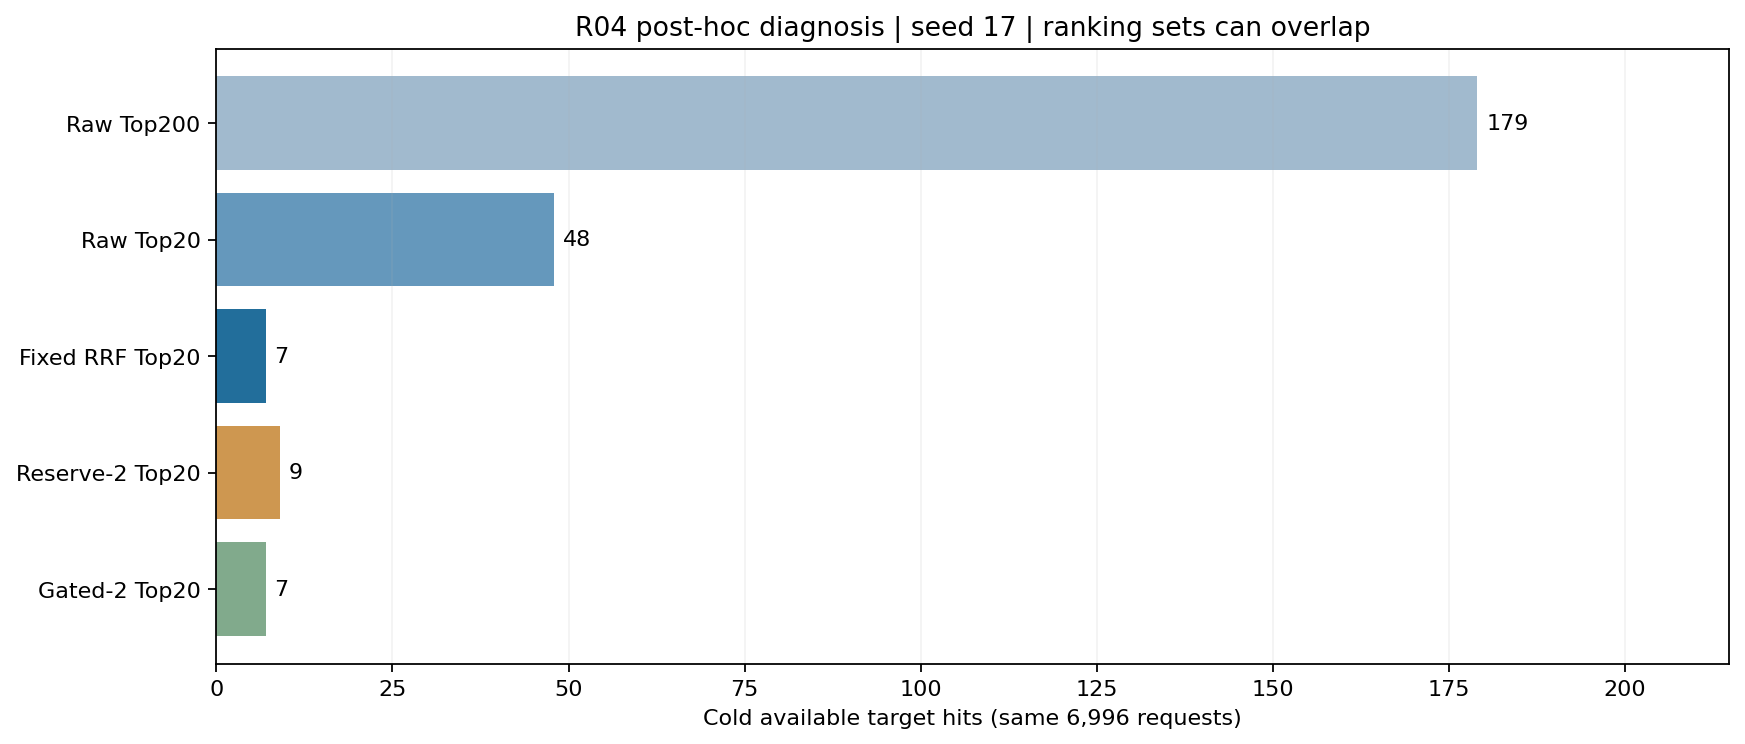
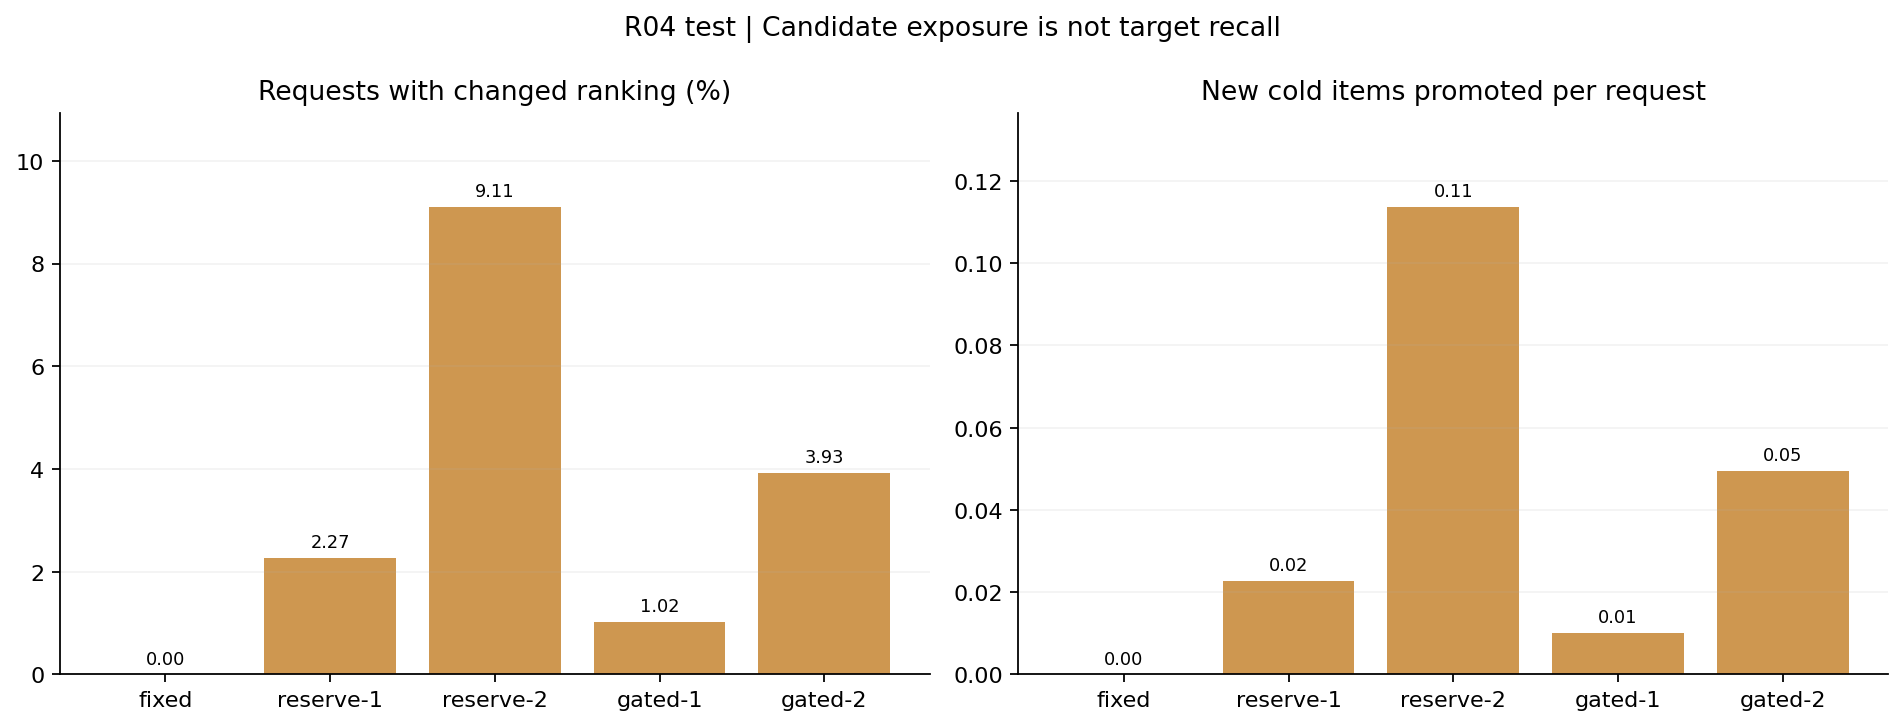
R04 已完成。 冻结 R03 模型,设计冷商品保留与门控策略。通过验证集比较五种预登记策略,分析冷商品在各检索阶段的落选位置。门控机制根据历史信号动态调整召回路径,在不跳过任何检索通道的前提下提升冷商品曝光。
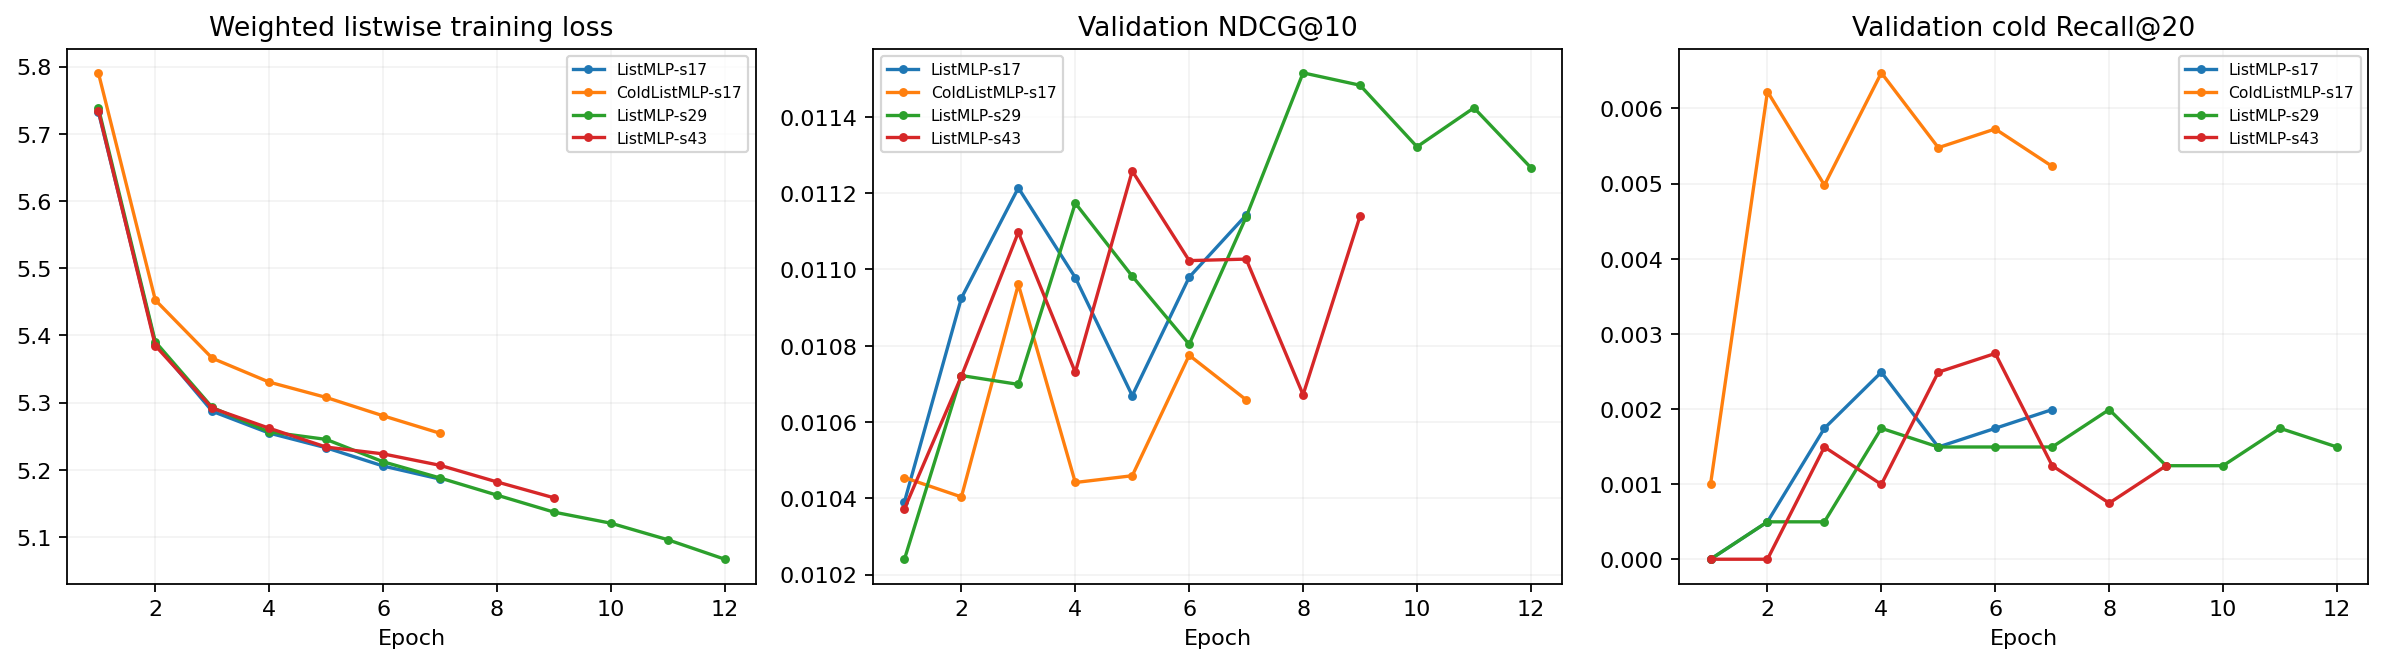
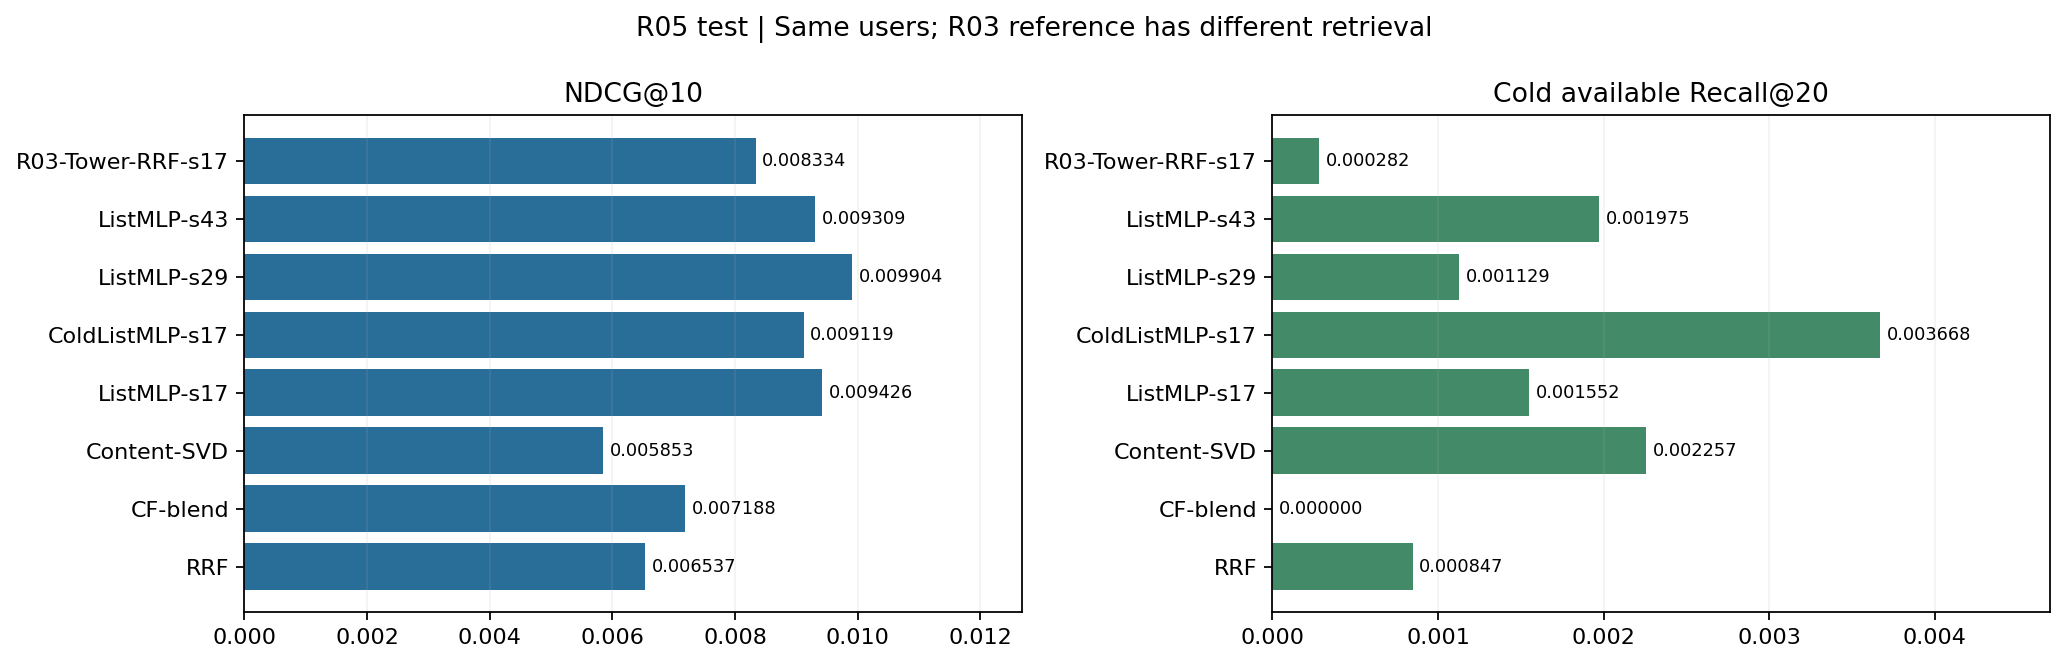
R05 已完成。 引入新排序模型 ColdListMLP,针对冷样本进行加权训练。完成 35 轮训练,在相同候选池下与普通 ListMLP 进行对比。冷样本加权策略在保持整体性能的同时提升冷商品排序效果。
六、第三阶段:理解与实现推荐方法
- 从简单基线开始,逐步理解序列推荐与内容检索。
- 如何阅读 TIGER、LIGER 等相关工作。
- 商品内容向量、语义 ID 和用户表示分别是什么。
- 新商品加入后,各条检索路径如何处理。
- 为什么提出预算路由,以及它依赖哪些信息。
- 论文实现与统一实验协议之间有哪些差异。
每个方法按“问题 → 原理 → 小例子 → 实现 → 验证”的顺序讲解。当前仍在计划阶段,后续将区分论文复现部分与统一实验协议所做的修改。
七、第四阶段:用实验检验想法
- 实验要验证的假设是什么。
- 为什么选择这些基线与评价指标。
- 如何比较整体、冷物品和低频物品表现。
- 如何保证不同方法的候选范围和计算预算可比。
- 消融实验如何判断每个模块的作用。
- 哪些实验没有提升,可能原因是什么。
- 哪些观察可以形成结论,哪些还需要更多证据。
每张结果图注明数据版本、样本数、运行配置和测量条件。目前已有基线结果与训练曲线,但预算路由、内容检索和生成式方法尚未完成统一对照;均值不替代不确定性分析。
八、第五阶段:把算法接入可操作的系统
- 一次推荐请求如何经过各个模块。
- 用户收藏、屏蔽和撤销如何影响后续请求。
- 新品如何完成校验、编码、索引构建与发布。
- 模型、物品映射和索引如何保持版本一致。
- 发布失败、请求超时和版本回滚如何处理。
- 前端怎样展示真实状态与实验结果。
当前已完成领域对象和应用层版本检查,数据库事务、模型推理、发布协调与页面截图仍待接入。
九、第六阶段:性能分析与 C++ 优化
- 如何测量排队、模型、检索和后处理耗时。
- 实际瓶颈出现在哪里。
- 为什么选择某个模块进行优化。
- Python 与 C++ 的接口、数据传递和生命周期如何设计。
- 优化前后的正确性、内存和延迟对比。
- 如果收益不足,最终保留了什么实现。
这一节在获得测量结果后展开,记录优化成立的条件。性能阶段尚未开始,只有确认实际瓶颈后才决定是否引入 C++/pybind11 扩展。
十、最终展示与阶段复盘
- 最终完成了哪些功能,哪些仍在规划中。
- 如何启动项目并重放完整演示。
- 哪些研究假设获得了支持,哪些没有成立。
- 最值得保留的技术决策和最想重做的部分。
- 对推荐算法、C++ 和工程协作的理解发生了什么变化。
- 下一版本准备解决什么具体问题。
当前可交付物是离线基线数据、训练报告与框架检查记录;线上推荐体验、商品工作台、策略对比和效果看板仍需独立验收。
十一、持续更新日志
每次更新采用固定格式:
YYYY-MM-DD|本次推进的主题
- 本次问题: 为什么需要推进这项工作。
- 实际改动: 修改了哪些设计、代码或实验配置。
- 验证过程: 使用什么输入与方法检查。
- 结果与证据: 数据、截图、日志或对应代码版本。
- 遇到的问题: 失败现象、排查过程与尚未确认的解释。
- 当前结论: 本次工作能够支持什么判断。
- 下一步: 一个具体、可验证的任务。
若后续结果推翻旧结论,保留旧记录,并注明修正日期和原因。
2026-09-15|真实基线、用户采样与持续训练报告
- 实际改动:完成 R01 热门 / ItemCF 实验、R02 完整用户采样、R03 三种子序列训练和自动曲线。
- 结果与证据:226,172 条交互、39 个 epoch;序列模型三种子测试均值为 0.005628 ± 0.000222,低于时间衰减协同融合的 0.008380。
- 当前结论:更复杂的网络没有自动战胜时间先验;6,874 个模型冷且可用目标全部未命中,冷商品可达性是下一轮首先要解决的问题。
- 下一步:补充内容候选路径,冻结评价窗口后重新比较整体、冷物品和低频物品。
2026-09-16|内容双塔、门控策略与冷样本加权排序
- 本次问题:R02 发现 6,874 个模型冷目标全部未命中。纯协同过滤方法无法处理训练期间未见过的商品,必须补充内容检索路径。即使有了内容路径,如何在不降低整体效果的前提下提升冷商品曝光,以及如何在排序阶段更好地平衡冷热样本,也需要专门设计。
- 实际改动:
- R03:实现内容双塔架构,使用商品标题、品牌和类别构建语义向量;完成 48 轮训练;设计协同+内容的混合召回策略。
- R04:冻结 R03 模型,设计五种冷商品保留与门控策略;在验证集上选择最优策略,测试集上进行消融实验;分析冷商品在召回、粗排、精排各阶段的落选位置。
- R05:引入 ColdListMLP 排序模型,对冷样本进行加权训练;完成 35 轮训练,在相同候选池下与普通 ListMLP 对比。
- 验证过程:统计训练集商品词表覆盖率、测试集冷商品占比;检查 Amazon Review 数据集元数据字段完整性;使用 Sentence-BERT 编码商品内容并构建 Faiss 索引;在验证集上比较门控策略效果后锁定配置;训练冷样本加权模型并在测试集上评估。
- 结果与证据:
- R03 内容融合改善整体 NDCG,但冷商品命中率低于预期;测试集中约 75% 的目标商品在训练时未被观察到。
- R04 门控策略在验证集上选出最优配置;测试集消融实验显示门控机制能够在保持整体性能的前提下提升冷商品曝光;落选位置分析表明大部分冷商品在召回和粗排阶段被过滤。
- R05 冷样本加权排序模型在保持整体性能的同时提升冷商品排序效果;所有实验图表已整理到博客图片目录。
- 遇到的问题:
- 内容编码方案需要在效果和可控性之间权衡(最终选择 Sentence-BERT)。
- 混合召回的融合权重、候选数量分配需要多次实验调优。
- 门控策略设计需要显式考虑商品是否在词表、用户历史长度等条件。
- 冷样本加权需要平衡整体性能和冷商品效果,权重过大会损害整体指标。
- 当前结论:
- 纯协同过滤方法在词表外商品上完全失效,必须引入内容路径作为独立召回通道。
- 混合召回需要显式设计路由策略,单一方法无法解决所有场景。
- 门控机制能够在不跳过检索路径的前提下动态调整召回策略,提升冷商品曝光。
- 排序阶段的冷样本加权是补充手段,主要提升仍来自召回和粗排的覆盖范围。
- 下一步:完善在线业务接入,将离线实验结果集成到可操作的推荐系统;补充前端展示与效果看板;记录真实用户交互数据用于后续迭代。