Raft-KV 项目介绍:一致性存储、故障恢复与有界并发
2026-10-27 · 持续更新
阅读路线:请求经过哪些模块 → 写入何时返回成功 → 故障下怎样验证 → 有效的重连优化 / 未观察到收益的客户端优化。
本文从早期的 RESP 写请求出发,讲解持久化、Raft、多副本故障与性能取舍。项目已继续发展:截至 2026-10-27,当前代码支持可选 ReadIndex 线性一致读、租约读、快照与安装恢复、IDEMP 重试身份,以及有界并发;这些实现与已有证据不是同一层面的结论。
本文主体的细节、数字和“尚未实现”条目对应固定的历史文章归档 051ca62934301a22df21c03e7ba37299b161ff0b。后文保留它作为工程改造过程记录;最新能力和验证请先读本段后的更新摘要与第十节,性能数字也只适用于各自归档实验。
当前代码与验证锚点:项目状态和测试注册表已同步到 65bbd9d,该文档提交所对应的源码与测试基于已在 Linux 验证的 30d29ef。具体验证范围与未覆盖事项列于当前项目状态和验证记录。
项目当前状态(2026-10-27)
Raft-KV 是 C++17 固定成员、三节点默认配置的单 Raft 组 KV 服务,使用 Muduo、Protobuf 与 RocksDB,提供 RESP 命令接入、命名空间、Pre-Vote/CheckQuorum、多数派写入、串行异步应用、有界队列与过载保护。写入成功回调发生在日志多数派提交和状态机应用完成之后;KV 与 lastApplied 同批落盘。
当前代码另有可选 ReadIndex 线性一致读、可选租约读、自动快照、分块快照安装与恢复,以及 IDEMP 最近请求去重。它们均非默认所有读写模式:默认 GET 是本地读,可能读到旧值;leader_only_reads 只检查角色,不等于线性一致读。服务不支持动态成员变更或多分片。
当前本地验证:提交 30d29ef 在 Debian Docker 环境用真实 Muduo、Protobuf、RocksDB 完整构建并完成 20/20 CTest、80/80 Python 辅助测试、三节点故障/恢复冒烟,以及 ReadIndex 集成脚本 4 passed / 0 failed / 0 skipped;其后的 65bbd9d 是 README 与状态文档同步提交。四场景集成不覆盖持续少数派分区;Linux CI 的分区、写入重启与过载属于单独工作流,不把本地结果扩展为全部 CI 或生产验收。性能数字仍来自各自历史条件,不在当前源码上复测。
现有证据不覆盖整机掉电、介质损坏、长期压测、多机独立故障域或完整 Raft 正确性证明。快照过大时保留日志,不能保证日志占用有硬上限;两个数据库间的快照恢复也不是跨库原子事务。相关细节见状态与边界、读一致性和快照安装恢复。
一、项目问题与目标
Raft-KV 将 C++ 网络服务、Raft 共识、持久化与故障恢复放进同一条请求链路。客户端收到成功之前,系统需要完成请求校验、日志复制与多数派提交、状态机应用和持久化;连接中断、写入失败、Leader 切换和超时都会影响最终结果。
KV 存储的业务接口相对简单:保存一个键值、读取一个值、删除一个键。由此可以聚焦网络与系统问题:保留 TCP 分片输入、让副本按序执行命令、恢复应用进度,并在高负载下限制请求积压。
这些能力对应 C++ 后端及搜索、广告、推荐基础架构中的网络接入、配置与元数据存储、服务可靠性和性能诊断。当前项目实现通用 KV 与一致性机制;版本化策略配置演示仍是后续计划,推荐模型、召回和排序算法不在实现范围内。
项目来源、许可证与改造范围
目前维护的仓库是 Die4U23/Raft-KV,采用 C++17、Muduo、Protobuf 和 RocksDB,默认运行一个固定成员的三节点 Raft 组。
项目早期参考过已有代码和教程。最初教程链接与部分代码来源暂未找回,因此本文不把全部基础实现声明为原创;如找回相关资料,将补充出处与致谢。
目前可追溯的工程改造,以仓库 raft-cluster-namespace 分支的以下提交为起点:
基线已经包含网络接入、Raft 共识、状态机、RocksDB 存储及命名空间等模块。本文重点介绍此后开展的正确性修复、故障恢复验证、请求处理改进、重连退避优化,以及性能诊断与对照实验。这个基线用于界定本次改造的起点,不构成对更早代码来源或原创归属的认定。
正文归档版本当时尚未包含项目级许可证声明。2026-09-16 起,默认分支已增加 MIT LICENSE 与 NOTICE;第三方组件许可仍需单独核对,不从依赖许可证推定整个项目许可。已知组件的官方入口列在文末;许可证补齐细节见更新日志对应条目。
二、文章归档版本的能力基线
下面的表格还原本文归档提交 051ca62 当时的状态,不能作为当前能力表使用。当前版本已增加表后更新中列出的功能;“已实现”与“已验证”仍要按源码版本、环境、输入与故障范围分别判断。
| 能力 | 实现状态 | 已有验证 | 归档版本当时的边界或计划 |
|---|---|---|---|
SET、GET、DEL |
已实现;DEL 按键是否存在返回 1 或 0 |
本地协议/核心测试,Linux 三节点冒烟 | 支持项目定义的命令子集,不是完整 Redis 服务 |
| 命名空间 | 已实现;SELECT 选择当前连接的命名空间 |
同连接命令顺序及空间隔离检查 | 新连接默认 default;只是逻辑键空间划分,不含权限和资源隔离 |
| 选举、日志复制、多数派提交 | 已实现;单 Raft 组、固定成员配置,默认三节点 | 真实三进程冒烟、短时 TCP 分区、Leader 退出与恢复 | 没有动态成员变更,也没有多分片扩展 |
| RocksDB 存储与应用位置恢复 | 已实现;KV 与 lastApplied 同批同步写入 |
本地错误注入与恢复测试,Linux 进程强制退出后恢复 | 要使用配套数据目录;没有整机掉电或设备损坏实测 |
| 批量写入、串行异步应用 | 已实现;异步应用默认开启 | 顺序、回调、配额测试及真实 Linux 运行 | Raft 日志写入与本地读仍可能阻塞事件循环 |
| 过载保护 | 已实现;限制连接、队列、提案及缓冲字节 | 指定阈值下的准入拒绝、BUSY、恢复清零和约 60 秒观察 |
应用配额不是进程内存上限,短时观察不等于长期稳定 |
INFO 与阶段耗时 |
已实现;角色、任期、提交/应用位置、队列和耗时计数 | 阶段差分、CPU 和报告身份核验 | 没有 Prometheus 导出,阶段计数器不提供请求延迟直方图 |
| ReadIndex 强一致读 | 计划中 | 尚未完成对应实现和验收 | 当前 GET 是本地读 |
| 请求去重 | 计划中 | 尚未完成对应实现和验收 | 超时或回复丢失后的重试可能重复执行 |
| 快照、日志回收、动态成员变更 | 计划中 | 尚未完成对应实现和验收 | 日志持续增长和落后副本恢复能力仍需完善 |
实现入口见归档源码,验证依据见本地改造记录及第六节逐项报告。
历史说明:在上述归档版本里,GET 直接读取当前节点状态机,leader_only_reads=true 仅检查本机角色,不能抵挡网络隔离中的旧 Leader 返回过时值。当前源码已提供独立的 --linearizable_reads=true ReadIndex 路径;默认 GET 仍是本地读,Leader-Only 仍不是线性一致读。详见本文更新摘要中的读语义入口。
三、系统架构:一次请求经过哪些模块
写请求的主路径是:客户端 → Muduo 接入层 → 命令处理 → Raft → 状态机 → RocksDB。下图概括写入、默认本地读与可选 ReadIndex 的路径;当前读路径还可按启动参数选择满足时钟假设时可用的租约读,图中省略网络接入、组批与线程通知细节。
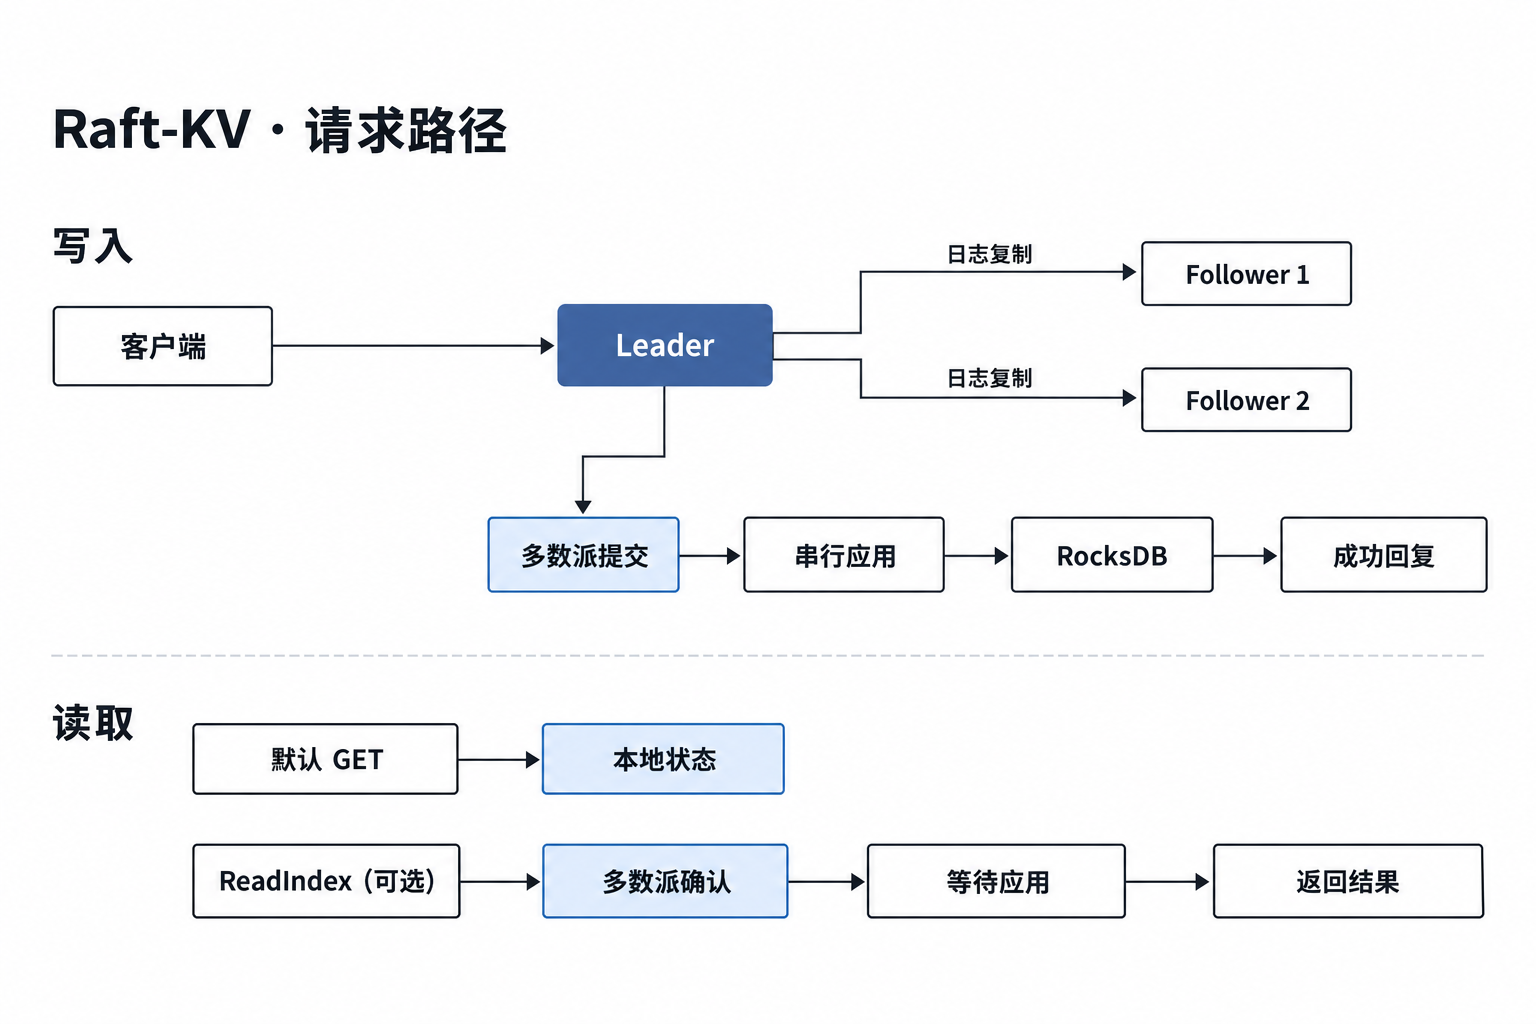
各模块的职责如下:
| 模块 | 在项目中的职责 |
|---|---|
| Muduo | 管理 TCP 连接、输入输出缓冲与事件循环,驱动客户端命令和节点间消息处理 |
| Protobuf | 定义和序列化投票、日志复制等节点间消息;消息外仍需要项目自己的 TCP 帧边界 |
| Raft | 管理任期、投票、日志匹配、复制进度和多数派提交,不直接解释业务键值 |
| 状态机 | 按日志顺序把已提交命令转换为确定的 KV 修改和回复 |
| RocksDB | 分别保存 Raft 日志/硬状态,以及业务数据/应用位置 |
这些分工可以对照 Muduo 官方仓库、Protobuf 概览及项目服务入口阅读。
这里的关键是线程归属。事件循环线程负责网络回调、批量调度、Raft 状态变化以及应用完成通知;默认启用的工作线程只负责已提交批次的 KV 应用。工作线程不会独立推进 Raft 提交位置,也不会直接操作客户端连接。
同一个 RaftNode 同时最多有一个应用批次在途。“在途”包含工作线程已经做完、但事件循环尚未处理完成通知的时间。这样可以保持批次顺序,避免后面的应用越过前面的应用。
异步应用没有把所有磁盘工作移出事件循环。 Raft 日志与硬状态读写、准备应用批次时读取日志,以及客户端本地 GET 仍在事件循环线程执行。它们仍可能影响心跳和网络处理。async_apply=false 则把 KV 应用也放回事件循环,作为同步执行的对照路径。机制见并发处理说明;该早期文档中的“未运行”文字属于历史状态,当前验收情况以第六节带日期的报告为准。
四、一次写入,什么时候才能返回成功
以一个发送到 Leader 的 SET user:1 alice 为例,成功路径如下。下图按先后顺序展示关键步骤;正常情况下 Leader 向两个 Follower 发起复制。
- 接入与组批:事件循环收齐请求,解析、校验、展开命名空间并检查配额,然后进入有界写队列。
- Leader 日志落盘:命令批次交给 Raft,先在 Leader 日志库中同步持久化;成功后再发起复制。
- Follower 确认:Follower 接收 AppendEntries,校验日志匹配并同步持久化,再回复对应 RPC 的成功确认。
- 多数派提交:Leader 检查请求身份、日志位置及任期规则;达到提交条件后推进
commit_index。 - 状态机应用:Raft 将已提交的连续日志批次交给串行工作线程,在同一 WriteBatch 中同步保存 KV 修改与
lastApplied。 - 完成通知:持久化成功后,工作线程将通知排回事件循环;事件循环更新应用位置,释放提案配额,按序完成回调。
- 发送回复:接入层向客户端发送
+OK。输出缓冲另有配额;发送回复本身不保证客户端一定收到。
具体来说,请求先经过完整性、参数及大小校验,再检查连接状态、Leader 角色和队列容量。命名空间会在这时展开到业务键中,展开后的完整命令也必须满足大小限制。
写队列默认使用 group_commit_ms=1 的收集期限,满批则提前排入事件循环。当前组批阈值为 128 条或 1 MiB 命令数据。这个 1 毫秒是调度目标,实际等待还受事件循环与磁盘工作影响;设置为 0 也可能合并同轮到达的请求。
Leader 将日志批次同步写入自己的日志库,再通过 Raft RPC 复制。三节点中的多数派是两个节点:对正常的新写入,Leader 自身和一个 Follower 持久化成功,就可能满足数量要求。代码还必须验证回复对应的请求、日志位置与任期条件,不能把任意两次 ACK 当成多数派。Raft 对当前任期条目的提交规则,也不能省略。
提交之后,状态机才依次执行命令。KV 数据和该批次最后一个日志位置 lastApplied 在同一个同步 WriteBatch 中保存。工作完成通知回到事件循环后,Raft 才更新自身的应用位置,释放未完成提案配额,并调用成功回调。对应实现见 RaftNode::FinishApply与存储批量应用。
三种状态的含义不同:
| 状态 | 已经发生的事情 | 此时不能据此断言什么 |
|---|---|---|
| 日志已经写入 | 某个节点保存了这条日志 | 单节点保存不代表形成多数派;未提交的冲突日志仍可能被后续 Leader 覆盖 |
| 日志已经提交 | 已满足 Raft 提交规则,可以按顺序应用 | 业务 KV 可能还没更新;各 Follower 的应用进度也可能不同 |
| 日志已经应用 | 该节点执行了命令;本项目要求业务修改与应用位置保存成功 | 不能保证客户端收到回复,也不能保证所有副本已经应用到同一位置 |
因此通常有 last_applied ≤ commit_index ≤ last_log_index。异步模式下看到 commit_index 领先于 last_applied,意味着存在已提交但尚未完成应用通知处理的日志,不应立即判断为副本错误。日志提交与客户端交互的算法背景见 Raft 论文第 5、8 节。
配额也分阶段释放:写队列条目出队时释放队列配额,应用完成时释放对应的未完成提案配额,网络输出积压另行跟踪。不能把“写请求结束”理解为所有缓冲已经送达对端。
客户端超时为什么不代表失败或撤销
客户端可能在日志写入前断开,也可能在日志已经提交、业务已经应用后,因回复丢失而超时。服务端不会因为调用方不再等待,就回滚已经进入 Raft 的命令。
这不是只有理论上的可能性:重连优化后的分区报告中,no-quorum-2 在故障窗口内没有得到成功确认,被记为结果未知,恢复通信后却被应用。正确记录应当同时保留这两个事实,不能把它改记为“故障期间写入成功”或“超时必定失败”。
在本文归档版本中,项目尚无请求去重。调用方重试时可能产生另一条日志;即使重复 SET 相同值最终看起来一样,重复 DEL 的返回值也可能由 1 变成 0。当前版本已增加 IDEMP 最近请求身份与结果持久化,具体保留规则见更新摘要中的当前状态链接。
五、围绕可靠性做了哪些改造
下面按“基线已有 → 问题 → 本次改动 → 验证 → 剩余边界”介绍,避免把使用了某个组件直接写成个人新增能力。
5.1 协议与请求处理
基线已有: Muduo 客户端接入、RESP 命令解析、基本命令分发以及连接级命名空间。
问题: TCP 提供字节流,一次接收回调不一定包含一条完整命令。基线从 Muduo 缓冲中取走全部当前数据后解析,未完整命令可能丢失;一次到达多条命令时,还要防止后续本地 GET 或 SELECT 越过正在等待提交的写请求。
本次改动: 为连接保留未消费输入,解析器明确区分 Complete、NeedMore、Invalid。只有完整命令才消费对应字节;半条命令继续等待后续输入;非法长度、参数和结束符进入错误处理。补充整数长度、参数数量、命令大小与命名空间展开后的限制。每轮最多解析 128 条命令,然后交回事件循环。
例如同一连接连续发送 SET k v、GET k、SELECT other,服务端会等前面的写请求完成后继续处理后续命令。当前每连接最多有一个等待结果的写请求,跨连接写入仍可合批。SELECT 的状态只属于该连接,两次单独运行客户端不会共享它。
验证: 本地协议目标覆盖分片拼接、连续命令、输入上限和错误边界;早期记录包含 274 项协议检查及 10,000 条命令连续解析。真实 Linux 冒烟进一步检查分片、二进制内容、跨轮流水线与命名空间。入口见解析器、命令缓冲和测试说明。RESP 长度和回复格式可对照 Redis 协议规范。
剩余边界: 本项目只实现所需命令和回复子集。-ERR MOVED <leader_id> 是项目自定义错误,不是 Redis Cluster 的完整重定向协议;同连接处理顺序也不能替代全局强一致读。
5.2 持久化与恢复
基线已有: RocksDB 日志存储、KV 存储封装和顺序状态机应用路径。基本的“提交后应用,再触发回调”结构原本已经存在。
问题: 基线的 KV 存储返回读写是否成功,但状态机没有据此阻止成功回复;读取错误也可能与键不存在混在一起。应用位置只保存在内存时,重启后难以可靠判断哪些日志已经改变了业务数据。
本次改动: 检查持久化返回状态,真实读取错误不伪装成键不存在,日志或硬状态保存失败不确认成功。将业务修改与该批次的 lastApplied 放进同一个同步 WriteBatch,存储成功后才发布应用进度。状态机先校验整批命令,再写入;批内重复操作保持顺序,例如 SET k v / DEL k / DEL k 分别返回 OK / 1 / 0。
假设日志 41、42 已经提交:若只保存业务数据而没有保存应用位置,重启可能重复应用;若只先保存位置,恢复又可能跳过未写入的数据。同批保存让恢复时的 KV 内容与应用标记来自同一次原子更新。RocksDB 的 WriteBatch 和 sync 分别对应批量原子更新及同步写入要求,具体说明见 RocksDB Basic Operations。
此外,本次改造还修正了共识路径中的若干边界:重复投票不重复计数,RPC 回复按请求身份匹配,日志前缀不匹配时不误删日志,不允许冲突覆盖已经提交但尚未应用的条目。这些属于对已有 Raft 实现的正确性修复,详细场景见本地核心验证记录。
验证: 存储替身覆盖同步写入选项、批内语义、写入失败、应用位置不误推进及重启补应用;真实 Linux 测试检查进程 SIGKILL 后从原目录恢复,以及已确认数据的保留。
剩余边界: Raft 日志库与 KV 库是两个独立数据库,不能把上述同批写入理解为跨库事务。恢复需要同一个节点配套的 db_path 和 raft_log_path;不能随意混用不同节点、不同时间点的目录。旧版非空 KV 库若缺少应用标记,当前会拒绝启动,应该保留旧数据并使用新的配套目录验证。当前也不支持混合版本滚动升级。同步写入的代码约定与进程崩溃测试,均不能替代整机掉电和真实磁盘故障验证。
5.3 异步应用与过载保护
基线已有: 在事件循环中执行已提交命令的路径,以及保存写请求回调的结构。
问题: KV 同步应用会占用事件循环;另一方面,把工作移到线程里,如果没有顺序约束、容量限制和生命周期设计,又会引入乱序、无限积压或回调访问已销毁对象的问题。
本次改动: 增加批量提案、串行工作线程和完成通知。工作线程仍使用同步持久化,异常回到事件循环后触发停止服务,不对落盘结果不确定的批次返回成功。待决请求的条数与字节一直保留到相应完成处理;连接回调使用弱引用,应用通知和定时任务检查对象生命周期或代际标记,防止旧回调继续操作新状态。
退出时停止接收新的应用任务,等待已接收任务结束并回收工作线程,然后再销毁其依赖;晚到的完成通知不能访问已析构的 RaftNode。这里验证的是具体执行器与对象生命周期路径,仍需要补充更广泛的进程信号和异常退出专项覆盖。
| 受限位置 | 当前限额 | 超限处理 |
|---|---|---|
| 客户端连接 | 默认 1024,可配置 | 关闭新增连接 |
| 单条命令 | 1 MiB,含协议与命名空间展开 | 拒绝超大命令 |
| 客户端未消费输入 | 单连接 4 MiB,合计 64 MiB | 关闭继续超量输入的连接 |
| 客户端待发送输出 | 单连接 4 MiB,合计 64 MiB | 关闭慢客户端 |
| 等待组批的写队列 | 1024 条、16 MiB | 返回 ERR BUSY |
| Leader 未完成提案 | 1024 条、16 MiB | 整批拒绝并返回 ERR BUSY |
| 每个 Raft 对端待发送数据 | 4 MiB | 暂缓整帧发送,由重发机制再尝试 |
这张表描述应用层的准入与积压控制。RocksDB 缓存、对象、系统 socket 缓冲和日志仍占用资源,所以这些数字不等于 RSS 上限;所有超限也并非统一返回 BUSY。
验证: 可移植核心测试控制“提交、工作线程执行、完成通知处理”的先后,检查只有一个应用批次在途、顺序推进及配额释放;线程执行器测试实际创建标准库线程。Linux 过载实验再检查拒绝、恢复和资源变化,具体结果见下一节。串行执行器和服务端配额实现提供代码依据。
剩余边界: 当前测试证明的是指定阈值和短时间负载下的行为,没有覆盖所有慢客户端、长期资源增长或极限容量条件。异步应用的性能效果也必须实测,不能仅凭线程数量增加就认定吞吐提升。
六、如何验证:让结论有原始证据
本项目把验证分成三个层次。它们相互补充,但不能相互替代。
| 验证层次 | 主要回答的问题 | 证据与局限 |
|---|---|---|
| 本地核心测试 | 分片输入、重复 ACK、冲突日志、存储错误、应用延迟等边界是否按预期处理 | 使用实际核心源码和可控存储/网络替身;执行器另用真实标准库线程。不能证明真实磁盘与 TCP 行为 |
| 真实 Linux 集成测试 | 实际 Muduo、Protobuf、RocksDB 和三个进程能否协同运行 | 保留编译、CTest、冒烟及运行时身份记录;同机环境有明确限制 |
| 故障与性能实验 | 指定故障下是否错误确认、恢复后数据是否保留、改动是否带来可观察收益 | 保留配置、日志、请求账本或客户端报告、源码指纹、二进制指纹记录及核验输出 |
早期可移植 CTest 有 5 个目标;增加重连策略后,Windows 记录为 6/6;重连版本的 Linux CTest 为 7/7,包含真实 Muduo 连接生命周期测试。这些分母来自不同版本和构建条件,不能合并成一次测试结果。
已完成的真实场景
| 场景 | 主要检查 | 归档结果 | 对应证据 |
|---|---|---|---|
| 三节点冒烟 | 选主、分片请求、流水线、命名空间、并发连接、复制与原目录恢复 | 多轮构建验收均有 10 项 PASS;重连版本最终三节点提交/应用位置均为 42 | 重连版本构建与冒烟 |
| 短时 TCP 分区 | 少数派不成功确认新写入;多数派继续工作;完全失去多数派时提交/应用不推进 | 原分区实验 5 个阶段 PASS、81 份 INFO 快照;4 个探测请求没有成功确认 | 分区报告 |
| 持续写入时 Leader 退出 | 故障期间客户端继续尝试,新 Leader 接管后继续确认写入,旧节点恢复后追平 | 5 个阶段 PASS;1,704 个已确认键在两次恢复后的三个副本中均保留 | 写入与重启报告 |
| 过载与短时持续运行 | 连接准入、写入积压拒绝、恢复清零、有限窗口资源变化 | 4 个阶段 PASS;5 个超额连接关闭、4 次明确 BUSY;约 60 秒正式观察及卸载后清零通过 | 过载报告 |
分区脚本通过 TCP 转发器控制节点间的有向连接。隔离阶段核对跨分区边的转发字节没有增长,同时记录各节点的角色、任期、提交位置和应用位置。旧 Leader 还自称 Leader,并不表示它能够形成多数派或确认新写入;观察重点是实际提交和客户端结果。
持续写入实验单独保留请求账本:
| 请求分类 | 数量 | 判定方式 |
|---|---|---|
| 客户端确认成功 | 1,704 | 两次恢复后,三个副本逐键检查精确值 |
| 明确拒绝 | 64 | 保留 MOVED/BUSY 等拒绝结果,不计入成功 |
| 结果未知 | 8 | 请求已发送但未读取到回复,不能假定失败或撤销 |
| 未发送 | 56 | 发送前连接失败,单独记录 |
| 合计 | 1,832 | 序号连续、键唯一,没有针对同一个键重试 |
在本轮中,8 个未知请求恢复后均不存在,但这只是本轮结果。测试先在持续写入期间强制退出 Leader,再恢复该节点;全体节点同时强制退出发生在持续写入停止、第一次数据核验完成之后。 因此不能把它表述为“持续写入时整个集群同时崩溃的验证”。完整时序见请求账本与故障记录。
过载实验把 max_clients 设为 32,其中一个名额用于监控;没有据此验证默认 1024 连接的实际承载能力。隔离期间,24 个客户端各发送一个 800 KiB 值,得到 4 次 BUSY 和 20 次结果未知。恢复后再进入固定键短时负载,卸载后的 10 份采样显示队列、待处理提案、输入输出积压和应用滞后为零。
该轮三个节点的稳态 RSS 增长约为 0.777、0.385、0.777 MiB,FD 增长均为 0。这里的增长使用正式阶段末 10 份与前 10 份采样的中位数差;采样峰值可能遗漏瞬时峰值。该负载还主动间隔发送,属于资源观察,不能拿包含预热的请求总数除以 60 秒生成正式吞吐。定义与阈值见过载原始报告。
测试结论的边界
三进程同机能够验证真实网络和存储依赖参与的特定行为,但三个进程共享宿主机、电源、磁盘和调度资源,不能称为三机容灾实测。SIGKILL 终止进程,没有模拟整机断电或设备损坏;60 秒观察也不能证明长期无泄漏。
当前分区验证覆盖短时、对称的 TCP 断连/拒绝连接场景,尚未覆盖静默丢包、非对称分区等完整网络故障空间。测试里的本地读通常在等待恢复和应用收敛后执行,不能由此证明并发历史的线性一致性。
归档中的源码清单、文件哈希与二进制哈希记录提高了可追溯性,但包内未必包含二进制和数据库本体,也没有每次 GET 的独立请求/回复转录。核验可以重算已有数据、检查脚本与报告对应关系,不能补出当时没有记录的证据,更不等于第三方独立运行或完整正确性证明。
2026 年 9 月 14 日整理本文时,重新运行了八项只读归档核验:自动构建、空目录构建、分区、持续写入重启、过载、重连退避、正常负载诊断和客户端读取对照,均为 PASS。这一步核对已有材料,没有重新执行 Linux 集群或产生新的性能实验。
七、一次有效的优化:抑制反复断线后的重连开销
问题与定位
原分区实验的安全性检查通过了,但同时出现了另一个问题:TCP 转发器累计拒绝新连接 24,731 次,三个节点的完整日志达到 5,498,325 字节。故障期间没有错误确认新写入,并不意味着连接处理开销合理。
排查时,需要把两种情况区分开:一是连接一直没有建立成功,二是 TCP 已经建立,随后被对端立即关闭。原有 Connector 对建连失败已有退避;本次转发器会先接收 TCP 连接再关闭,触发的则是 TcpClient 已建连后的断线重连路径。项目原先启用了立即重连,因而在这种反复断线场景里快速创建连接并输出日志。
另一个过载实验曾出现 7,897 次拒绝重连,但负载和故障配置不同,本文不把它作为这次分区对照的基线。问题和调用路径见重连优化记录。
实现
本次在项目的 PeerManager 中调整已建连后的重试策略,没有修改原始 Muduo 依赖压缩包:
- 每个 peer 独立保存重试状态,断线后的等待按 500 → 1000 → 2000 毫秒增长,之后保持 2000 毫秒。
- 连接连续存在满 10 秒才重置退避,避免“刚连上就断开”不停回到最短等待。
- 用代际标记识别旧定时任务,处理重复回调和重复启动,并让对象销毁后的回调失效。
- 建连失败仍交给 Connector 原有退避,不在它已经连接或正在重试时重复调用连接入口。
代码入口是重试策略和 PeerManager。策略测试检查上限、稳定重置边界和 peer 状态独立;Linux 真实传输测试检查建连拒绝、建立后反复关闭、恢复后接收 Raft 帧,以及等待重连时销毁对象。
本次实测
| 指标 | 旧版 9cfcfd6 对应实验 |
新版 ef17ef7 对应实验 |
本次变化 |
|---|---|---|---|
| 转发器拒绝重连次数 | 24,731 | 11 | 约减少 99.96% |
| 三节点完整日志量,包含清理 | 5,498,325 字节 | 146,110 字节 | 约减少 97.34% |
| 两次实际隔离窗口 | 4.322 / 4.032 秒 | 4.293 / 4.087 秒 | 时长接近但不完全相同 |
新版同时通过 Linux 构建、CTest 7/7、三节点冒烟 10 项和分区 5 个阶段。少数派不能成功确认新写入、失去多数派时提交/应用位置冻结,以及恢复后收敛的检查均通过。原始材料与复算方法见重连实测报告。
日志量采用两边完整文件的大小。新版报告在结束清理前采样得到的是 146,022 字节,完整文件是 146,110 字节;若一边用快照、一边用完整文件,就会混用口径。
取舍
退避降低了本次故障场景中的反复建连与日志开销,也可能增加恢复等待。项目自己的断线等待上限是 2 秒;随后若建连仍失败,还会进入 Connector 原有、最长 30 秒的退避,不能据此承诺“两秒内恢复”。
两轮初始 Leader 分别为 0 和 1,选举、调度和故障窗口并不完全相同。这是一次同类场景前后比较,不能解释为所有环境都能获得相同比例收益。整轮测试耗时包含隔离、选举、标记写入、核验和清理,也不能当作 TCP 重连延迟。
本次有直接证据支持的收益是拒绝重连次数与完整日志量下降。没有 CPU 和正常业务吞吐对照,因而不据此宣称业务 QPS 提升。
八、一次未观察到收益的优化:合并客户端回复头部读取
为什么尝试
后续正常负载诊断发现,客户端消耗约 12.22 CPU 秒,约占单核 62.88%;整机平均 CPU 空闲约 4.97%。三个服务节点和负载进程同机,客户端本身也是资源竞争的一部分。但当时还没有函数级热点证据,不能认定客户端某个解析函数就是唯一瓶颈。
一个小范围尝试是合并 RESP 回复头部读取:classic 先读取类型字节,再读取头部行;combined-header 将二者合为一次 StreamReader 读取,尝试减少方法调用次数。它没有把任意完整回复合成一次读取,带正文的回复仍需按长度读取后续内容,也不保证底层系统调用次数一定减少。改动范围见客户端实验说明。
如何对照
四轮顺序为 classic → combined-header → combined-header → classic,即 A→B→B→A。这样可以把两种模式分散到测试前后,减少只比较相邻两轮时受时间趋势影响的风险,但不能消除虚拟机调度和同机资源竞争。
四轮使用同一个服务端二进制,32 连接、pipeline=1、128 字节 value、读写各半;每轮预热 10,000 次,正式请求 100,000 次。async_apply=true、group_commit_ms=1,同步持久化和多数派确认语义保持一致。合计 400,000 次正式请求,零错误。
完整结果
| 轮次 | 模式 | 初始 Leader | 成功吞吐(次/秒) | P99(毫秒) | 客户端 CPU 成本(微秒/次) |
|---|---|---|---|---|---|
| 1 | classic | 0 | 7117.85 | 9.223 | 108.2 |
| 2 | combined-header | 1 | 7405.43 | 10.218 | 104.8 |
| 3 | combined-header | 1 | 5957.23 | 11.685 | 138.8 |
| 4 | classic | 1 | 6338.65 | 16.918 | 119.2 |
| 按模式合并的指标 | classic | combined-header | 相对 classic 的变化 |
|---|---|---|---|
| 正式成功请求 | 200,000 | 200,000 | — |
| 正式总耗时 | 29.8254 秒 | 30.2899 秒 | — |
| 合并成功吞吐 | 6705.69 次/秒 | 6602.85 次/秒 | −1.53% |
| 客户端 CPU 时间 | 22.74 CPU 秒 | 24.36 CPU 秒 | +7.12% |
| 客户端 CPU 成本 | 113.7 微秒/次 | 121.8 微秒/次 | +7.12% |
数据来自客户端头部读取 ABBA 报告。合并吞吐按“总成功数 ÷ 总正式耗时”计算,CPU 成本按“总客户端 CPU 时间 ÷ 总成功数”计算。不能直接平均两个 QPS,也不将四轮 P99 平均成一个“合并 P99”。
结果与决定
本轮合并模式的吞吐下降约 1.53%,客户端 CPU 成本增加约 7.12%,没有观察到预期收益,所以继续保留 classic 默认;combined-header 留作显式实验选项。
这不意味着它在所有环境中必然更慢。第 2、3 轮使用相同模式和相同 Leader,吞吐仍明显波动。如果只选择第 2 轮,就可以拼出一个看起来有效的优化故事,但它忽略了同一实验里相反的结果。
这次实验完成的是一个有边界的决策:小范围改动经过完整对照,没有取得足够的收益证据,因此不切换默认,也不继续重复同配置挑选最快轮次。后续若继续优化,应先补函数级热点或隔离客户端争用的测量。
九、如何理解项目的性能数字
先说明环境与负载
本文重点使用的正常负载诊断和客户端 ABBA 实验来自双核 Ubuntu 26.04 VM,记录内核为 7.0.0-31-generic、Python 为 3.14.4,三个服务进程与一个负载进程同机运行。它们共享有限 CPU、内存和存储资源,不能视为独立服务端容量测试。
| 条件 | 本文正常诊断与客户端对照的设置 |
|---|---|
| 连接数 | 32 |
| Pipeline | 1,即每条连接一次只等待一个操作的回复 |
| Value 大小 | 128 字节,不含键、协议头及复制开销 |
| 读写比例 | 50% SET / 50% GET |
| 每轮预热 / 正式请求 | 10,000 / 100,000 |
| 应用方式 | async_apply=true |
| 组批窗口 | group_commit_ms=1 |
| 持久化 | 保留同步写入 |
| 读取语义 | 本地 GET |
对应环境记录见正常诊断报告和客户端对照报告。这些条件不能自动套用到分区、过载实验或更早的同步/异步 ABBA。
吞吐、错误率与 P99 分别说明什么
成功吞吐表示正式窗口内,每秒完成了多少个成功请求。本地 GET 和需要复制持久化的 SET 成本不同,读写混合结果不能直接称为纯写吞吐。错误率需要同时保留拒绝、断连、超时等分类,不能为了提高成功吞吐而把失败请求从总请求统计中隐去。
P99 描述报告所收集延迟样本的第 99 百分位,用来观察尾部等待,不是最坏延迟。该压测工具按批次统计延迟;本轮 pipeline=1,一个完整批次只有一次操作,才可以按这个前提理解其数值。未来改为 pipeline>1 后,不能继续把整批延迟写成单请求延迟。
一轮正常诊断记录如下:
| 指标 | 本轮结果 |
|---|---|
| 正式成功 / 错误 | 100,000 / 0 |
| 正式耗时 | 19.433 秒 |
| 成功吞吐 | 5145.92 次/秒 |
| P50 / P95 / P99 | 5.242 / 14.631 / 21.663 毫秒 |
| 客户端 CPU | 12.22 CPU 秒,约占单核 62.88% |
| Leader CPU | 11.43 CPU 秒,约占单核 58.81% |
| 两个 Follower CPU | 分别约占单核 16.77% / 16.05% |
| 整机平均 CPU 空闲 | 4.97% |
这些 CPU 百分比中,进程值按“单核 = 100%”表示,整机空闲值则按整机容量表示,不能把两种分母直接混加。正式吞吐窗口排除了预填充、预热、建连和连接清理;原始报告没有保存逐次延迟序列,所以现有材料能够核对 P99 报告值及样本数,不能从原始延迟重新计算分位数。测量窗口与数据来源
为什么不能跨轮次直接计算“性能提升”
较早的同步/异步 ABBA 基线中,异步合并吞吐约为 3825 次/秒;之后正常诊断约为 5146 次/秒,再之后客户端实验的 classic 合并吞吐约为 6706 次/秒。
这些数字来自不同实验,测量窗口、运行时状态、工具和环境背景需要分别核对。不能把它们排成一条“持续优化提升曲线”,也不能将后来的 classic 比早期诊断更快,算到 combined-header 改动上。只有明确控制变量、保留所有轮次并使用同一统计口径,才能讨论某项改动与差异的关系。
为什么阶段平均耗时不能简单相加
INFO 的阶段计数从进程启动累计。对同一进程、没有重启的两个快照,区间平均耗时应该按 Δtotal_us / Δcount 计算;分母为 0 表示该区间没有样本。累计平均值相减不是区间平均,累计最大值相减也不是区间最大值。
正常诊断中的 Leader 阶段差分如下:
| 阶段 | 样本数 | 平均耗时(微秒) | 样本单位 |
|---|---|---|---|
| 写入排队 | 50,000 | 1080.61 | 客户端条目 |
| Leader 日志写入 | 5,681 | 118.80 | 日志批次 |
| 复制数据确认 | 11,322 | 1191.43 | 携带数据的 RPC |
| KV 应用 | 5,666 | 151.44 | 应用批次 |
| 应用完成通知派发 | 5,666 | 464.14 | 应用批次 |
| 写入完成 | 50,000 | 3608.33 | 成功完成回调的写请求 |
| 本地读取 | 50,000 | 14.89 | 本地 GET |
日志写与 KV 应用平均每批约 8.80、8.82 条。一批日志可以服务多个请求,一条 RPC 也可能覆盖多个日志;复制确认还可能来自不同 peer,阶段的统计区间又可能重叠。将表中均值相加,得到的不是任何一类真实请求的总延迟。
此外,write_completed 到服务端成功回调为止,不含回复到达客户端的时间;replication_data_ack 包含缓冲与重试,不是纯网络 RTT,也不是多数派提交耗时。定义见并发指标说明,数值见阶段差分报告。
现有数据能够支持的判断是:本轮同机资源余量较小,客户端值得纳入诊断,阶段计数可以帮助缩小调查范围。它还不足以定位唯一瓶颈、推出独立服务端容量,或预测三台物理机及更大集群的性能。完整 JSON、日志与核验材料通过文末仓库索引提供。
十、当前边界与后续方向
早期文章归档把 ReadIndex、请求去重、快照列为计划;这些功能已在当前源码中实现,并在上方按当前版本重述。下表只列当前仍未交付或未获充分验证的事项,历史计划和旧状态不再代表现状。
| 优先级 | 计划 | 准备解决的问题 | 预期验收方式 |
|---|---|---|---|
| 1 | 版本化策略配置示例 | 展示 KV 写读语义在具体配置发布场景中的用法 | 演示配置发布、按版本读取、本地缓存与回滚,并说明缓存新鲜度与失败语义 |
| 2 | 扩大故障与恢复覆盖 | 既有证据只覆盖指定网络与进程故障 | 在独立环境补充掉电/存储故障模型、更多网络组合和长时间运行证据,并保留原始身份和日志 |
| 3 | 日志容量与动态扩展 | 快照超出 payload 上限时保留日志;集群固定成员、单组单分片 | 明确日志长期容量策略,再单独设计和验证成员变更或分片方案,不从当前快照功能推断已有支持 |
ReadIndex 的当前实现依据请求之后发出的探针 ACK、多数派确认和应用位置等待;租约读另依赖单调时钟与新鲜度假设,租约不成立时退回 ReadIndex。这些语义不能简化成“只让 Leader 读”。算法背景可参考 Raft 论文第 8 节;对外读写语义可对照 etcd API 一致性保证。
上述后续方向是计划,尚无实现或验收结论。当前实现细节和功能边界以仓库状态说明为准;历史性能与故障数据仍以各自报告提交、机器和负载为准。
十一、持续更新日志
以下按验收或归档日期倒序维护;同日记录按本次整理顺序排列。每次更新保留“问题或目标、改动、验证、结果、取舍、证据”六项。代码发布早于实测归档时,分别注明,避免把工具发布当成实验完成。
2026-10-27|更新当前实现与验证状态
- 本次更新:将文章标题与项目定位改为一致性存储、故障恢复和有界并发;早期归档中的旧待办明确标为历史,当前能力在开头与第十节重新列明。
- 当前实现:ReadIndex、可选租约读、自动快照及分块安装恢复、IDEMP、Pre-Vote、CheckQuorum 与有界请求路径均有当前源码和状态记录。默认 GET 仍是本地读;动态成员和多分片仍未实现。
- 验证证据:Linux 本地构建对应源码提交
30d29ef:20/20 CTest、80/80 Python 辅助检查、三节点冒烟和 ReadIndex 四场景脚本 4/0/0 通过。文章对应的当前说明提交65bbd9d更新 README 与状态文档,没有把后续文档整理冒充为新代码测试。 - 未覆盖边界:四场景 ReadIndex 脚本不模拟持续少数派分区;本地测试也不能替代所有 Linux CI、整机掉电、介质损坏、长时间运行或完整正确性证明。历史性能数字没有在当前源码重新测量。
- 依据:README 当前验证、当前实现状态。
2026-10-06|打开日志时核对快照之后的每一条,并给出三节点演示
- 问题或目标:快照截断之后,日志中间损坏不应拖到以后读到那一条才发现;已应用但仍留在日志里的条数需要有上限;需要一条命令在本机走通三个进程。
- 本次改动:打开日志时读出快照之后的每一条,索引要连续,任期不能回退,否则进程在打开时失败。没有尾记录的旧库仍整库扫描一次并补上尾记录。
--snapshot_threshold默认 1024,达到后把已应用前缀换成 KV 快照,截断后留下的已应用条数小于该阈值。新增scripts/demo.py:选出 Leader、写入、三个节点读到、Follower 上的SET返回MOVED、杀掉 Leader 后新 Leader 仍能读旧数据并继续写、旧进程用原数据目录重启后再一致。--hold在结束前留下进程和端口。英文 README 作为默认README.md,中文说明改为README_CN.md。 - 验证环境与方法:三节点进程内测试用阈值 4 写入 20 条,Leader 和两个 Follower 都满足上限,并且第一条和最后一条都还在。演示是同一台机器上的三个进程,使用已有 Linux 服务。
- 实测结果:无新的吞吐对照,不填写性能数字。
- 取舍与未完成事项:演示不是多机容灾,也不替代分区和崩溃脚本。阈值只限制已应用后缀,其后的新条目会再积累到下一次截断。
- 关联提交、报告与原始证据:打开校验
3d59adb、阈值测试507ba4a、演示131fe1f、英文 README37e3781、当时 HEAD8fbb073。
2026-10-02|分区脚本补上静默丢字节、延迟、乱序和单向丢弃
- 问题或目标:正文归档时的分区只覆盖短时、对称的 TCP 断连和拒绝连接。
- 本次改动:
tests/raft_proxy.py增加silence()、delay()和reorder()。静默丢字节保持 TCP,恢复前先关掉已经丢过字节的连接,避免把后续字节接到缺前缀的流上。短延迟 40 ms,低于 150 ms 选举下限,字节仍按原顺序转发。长停顿 400 ms 只加在旧 Leader 与另外两节点之间,长过 300 ms 选举上限,多数派之间的链路不按住。reorder()只对调同一次读里已经完整的相邻 Raft 帧。另覆盖 Leader 到一个 Follower 的出站丢弃、一个 Follower 回复的单向丢弃、Follower 之间一个方向,以及 Leader 发往两个 Follower 的出站全部丢掉。TCP 在这些丢弃场景里不主动关闭。 - 验证环境与方法:Linux 分区测试与转发器单元测试。进程内测试把一条较旧的 AppendEntries 在更新的后缀之后重新投递。
- 实测结果:双向静默丢弃和只丢掉发往 Leader 的回复时,旧 Leader 不能确认探测写入,多数派仍能写入,恢复后收敛。40 ms 延迟和帧交换下写入仍提交到三个节点,任期和 Leader 不变。400 ms 停顿后旧 Leader 不能确认探测写入,另外两节点选出新 Leader 并完成写入,停顿取消后按住的字节仍按原顺序送出。只丢掉 Leader 到一个 Follower 的方向时,被丢掉的那一侧在恢复前读不到该键。Follower 之间再丢掉一个方向、并且 Leader 与两个 Follower 的方向都丢掉时,三个节点的提交和应用位置都不前进。Leader 出站全部丢掉时,两个 Follower 选出新 Leader;新 Leader 仍能把条目送到旧 Leader,所以不把旧 Leader 的提交位置冻结整段观察时间。
- 取舍与未完成事项:这些是脚本编排的字节路径,不是任意网络故障空间。乱序不放进短延迟那一组;长停顿那一组也不交换前后块。
- 关联提交、报告与原始证据:静默丢弃
0baf184、短延迟ca70f6f、长停顿45e63de、帧交换37be0cd、Follower 方向与 Leader 出站全丢e8fd1d6。无新的 09-13 式性能证据包。
2026-09-30|健康检查、运行镜像、快照半段重启,以及同步/异步同机对照
- 问题或目标:进程是否还活着需要一个不依赖客户端端口的检查;快照传到一半重启后的行为需要测试钉住;同步应用和异步应用需要在同一台机器上对照,而不是拿不同日期的吞吐相减。
- 本次改动:
--metrics_port上的GET /health在进程仍在跑且存储没有失败时返回 200,正文带角色、任期和 Leader;存储失败或已经停止时返回 503。Follower 也可以是 200,这不表示当前有多数派。docker/runtime.Dockerfile用 Ubuntu 26.04 编出服务,docker/compose.yaml起三个容器,各自挂独立的/data卷。冒烟在选出 Leader 之后、以及旧 Leader 重启并追上之后,对每个节点发GET /health,三个响应都要是 200,并且恰好一个角色是 leader。snapshot_tests增加半段之后重启、快照装完、随后的SET在落后副本上可读。tests/async_apply_compare.py一次只起一组三节点,先跑完pipeline=1的三次重复,再跑pipeline=16,每一轮交替哪一种--async_apply先启动,落盘仍是sync=true。 - 验证环境与方法:健康检查进入冒烟;分区、写入重启和过载脚本不打开这个端口。同步/异步对照于 2026-09-30 在 2 CPU、ext4(
/dev/sda2)上跑完 12 个单元。半段重启是进程内测试:副本发现 Leader 的 offset 对不上内存半段时回success=false,Leader 把偏移清回 0 再发整份快照。 - 实测结果:12 个单元里 11 个零错误;
pipeline=1、async_apply=true的一次重复里 Leader 因 CheckQuorum 卸任,6176 次MOVED。两种模式的吞吐区间重叠,这次结果不是稳定收益,不填写提升比例。原始数字在async-apply-compare-2026-09-30.json。 - 取舍与未完成事项:三个容器在同一台机器的一个 Docker 网络里。运行镜像不在 GitHub Actions 里构建。半段快照不落盘,重启即丢。
- 关联提交、报告与原始证据:健康检查与运行镜像
8be357b、冒烟检查/health6194190、半段重启fabd520、同步/异步对照2e20c66。
2026-09-29|提案超时、指标端口、故障测试进入 Linux CI
- 问题或目标:已受理但迟迟不提交的写不能一直挂着;
INFO需要能被抓取;分区、写入重启和过载要进 CI,而不是只留在手工脚本。过载 soak 在心跳抖动导致卸任时不应把测试判死。 - 本次改动:提案被受理之后,如果这条日志在 1000 ms 内还没有提交,回调
-ERR proposal timeout; outcome unknown,并把该请求移出待完成表。日志不删除,多数派稍后确认时仍会提交并应用,而且不会再回调一次。已经提交、只差应用完成的写不走这个期限。失去多数派时仍由 CheckQuorum 在 150 ms 后卸任。--metrics_port默认 0;设成与客户端端口、Raft 端口都不同的值后,GET /metrics返回 Prometheus 文本 0.0.4,字段与INFO相同,没有直方图,也没有当前连接的namespace。CheckQuorum 的 150 ms 从任期 no-op 写入并把第一条 AppendEntries 放进发送缓冲之后起算,不再把这次落盘时间算进“没有多数派应答”。复制帧没有进入连接发送缓冲时,不占用该 peer 的在途 RPC。linux-cluster.yml在冒烟和线性一致读之后跑cluster_partition.py、cluster_write_restart.py和cluster_overload.py。过载 soak 遇到 leadership lost、MOVED或断连时重新发现当前 Leader,并重试同一个 key/value,不算客户端错误。 - 验证环境与方法:提案超时有进程内测试:期限前不失败、到期后 Leader 还在且条目随后能应用、已提交但应用滞后的写不会被提前失败。故障脚本用同一次构建的服务;写入重启把
outcome unknown都记为结果未知,包括 proposal timeout。过载在隔离 Leader 时接受 CheckQuorum 卸任后的 leadership lost /MOVED,这些回复不算写入成功。 - 实测结果:仓库说明本机用当时的服务跑过这三份脚本。09-08 至 09-13 的性能对照没有重做,不把 CI 通过写成吞吐变化。
- 取舍与未完成事项:1000 ms 后告知结果未知,不是撤销已经可能提交的日志。指标端口与客户端端口分开,分区脚本不打开它。
- 关联提交、报告与原始证据:提案超时
2329c71、故障测试进 CIe22bb48、CheckQuorum 宽限8d17730、Prometheus 文本d783489、未发出的 Append 不占在途2682f40、过载跟随 Leader932e78c。
2026-09-28|快照、日志尾、IDEMP 与租约读
- 问题或目标:长期运行不能只靠追完整日志;超时重试不能让同一条
DEL执行两次;线性一致 GET 在租约有效时不必每读都发探针。 - 本次改动:已应用前缀可换成 KV 快照,并通过
InstallSnapshot传给落后副本。尾记录标出日志终点;拒绝复制时跳到冲突任期。空库跳过0/0日志尾写入。新写命令是IDEMP <client-id> <request-id> SET|DEL ...。request-id从 1 起,十进制且不能有前导 0;client-id为 1 到 128 字节。状态机为每个 client id 保存最近一次请求号和回复,与用户写入放在同一次 KV 批里,并随快照安装到其他副本。相同请求号再次提交时返回第一次的回复;更小的请求号返回-ERR stale request;更大的请求号会执行。--lease_reads默认关闭,只改变--linearizable_reads的 Leader GET:本任期已满最长选举超时(300 ms),并且多数派在最短选举超时(150 ms)内应答过,就用当前commit_index本地确认。last_applied还没追上时仍然等待应用。新任期的前 300 ms 不使用租约。Follower 仍然返回MOVED。同日还删过已被后续状态取代的设计文档,并整理.gitignore;这些不改变请求语义。 - 验证环境与方法:进程内测试覆盖租约的四个边界:新任期发探针、租约新鲜时不发探针、联系变旧时退回探针、未应用的提交不会提前完成读。IDEMP 的重复请求号、更小请求号和随快照安装,按仓库日志里的语义记录,本文没有单独的测试名称可引。半段快照的重启回归记在 2026-09-30。
- 实测结果:无独立吞吐对照,不填写性能提升比例。
read_index_lease只计本地确认的次数。 - 取舍与未完成事项:普通
SET/DEL仍然不去重。每个 client id 的记录不会过期;客户端换一个更大的请求号之后,更早的号不能再取回当时的回复。租约读避免和上一任 Leader 的选举窗口重叠,联系变旧时退回 ReadIndex。 - 关联提交、报告与原始证据:快照
43a0ae2、日志尾5b58ca5、IDEMP8a2c6b4、租约读2f2d40c。
2026-09-23|关掉 ReadIndex 残留,并加上 Pre-Vote 与 CheckQuorum
- 问题或目标:09-22 架构检查留下的 F1、F6 不能再按“已修补”结案;延迟 ACK 不能在多数派已经另选 Leader 之后仍确认旧读;没有多数派同意时不要先抬任期。
- 本次改动:读请求先进入未发送队列,一轮冻结后再发送的新 AppendEntries 才记入
probe_rpc_ids。请求之前已在途的复制、心跳及其重试不能确认该读。探针轮次只在最短选举超时(150 ms)内接受 ACK,过期 ACK 到达时立刻失败该轮。Follower 在选举时钟尚未到期、且已知当前 Leader 时,对其他节点的RequestVote既不抬任期也不给票。选举超时改成steady_clock上的绝对截止时间,ReadIndex 与选举使用同一把钟。补上 CheckQuorum:Leader 在最短选举超时之后如果没有多数派的 AppendEntries 应答,就在当前任期卸任,并失败未完成的读。预投票达到多数派之后才走原来的BecomeCandidate()。CTest 改为链接生产RaftNode或生产ClassifyCommand;每连接调度抽到session_queue.h,由connection_order_tests直接驱动。新增linux-cluster.yml:构建真实 Muduo/RocksDB 服务,跑三节点冒烟和tests/cluster_linearizable.py。线性一致 GET 在多数派确认之后、读状态机之前再看一次IsLeader(),已经卸任则MOVED。 - 验证环境与方法:进程内回归覆盖隔离节点多次超时不抬任期、恢复后原 Leader 任期不变且写入仍能在三副本提交、错过一轮任期的节点在 Leader 消失后能选出新 Leader,以及少数派自确认不能完成 ReadIndex。Linux CI 要求隔离旧 Leader 的 GET 在 1 秒内收到
read index timeout、MOVED或卸任错误,套接字超时不再算通过。可移植 CI 仍不构建真实服务。 - 实测结果:不把 CI 通过写成相对本地读的性能收益。09-13 的分区、崩溃重启和过载证据包没有为这次修补重做。
- 取舍与未完成事项:
--linearizable_reads默认仍是 false。CheckQuorum 先于 Pre-Vote 合入,两条都在 09-23 的main上。单节点集群在同一次超时里成为 Leader,CheckQuorum 只计自己。replication_ack_tests.cpp仍是 FakeRaftNode,不加入 CTest。 - 关联提交、报告与原始证据:探针绑定
75bee54、生产调度器与 Linux CIf83ca7a、拒绝过期 ACK272657d、拒绝干扰投票f717a8c、选举时钟对齐bf71129、Pre-Vote4e0fa4a。当时还没有快照和租约读。
2026-09-22|架构检查与 P1/P2 修补:生产路径仍有残留
- 问题或目标:核对 ReadIndex 与每连接队列改造是否达到 README 所称的线性一致读与正确排队;修补审查中的 P1/P2。
- 本次改动:对提交
831a91c做架构检查并写入审查报告。PR #9(60ddf84)修补 F1–F4:AppendEntries 响应用rpc_id关联读轮次;--linearizable_reads=true时 Follower GET 返回MOVED;每连接队列上限 1000 条 / 4 MiB;未知命令与参数错误走统一完成路径。PR #10(673fbb6)修补 F5、F7:非法命令以ERROR类型入队按 RESP 顺序回复;边缘用例测试用std::max<int64_t>消除 MinGW 推导失败。 - 验证环境与方法:本轮按生产代码与提交说明核对;提交说明称单测与冒烟通过。未重新执行历史 Linux 分区 / 崩溃重启 / 过载归档,也没有针对修补后的 ReadIndex 做隔离旧 Leader 的真实集群核验。
- 实测结果:无新的已核验 Linux 证据包。代码核对后 F1 仍未真正关闭:读轮次
round_id来自_next_round_id,匹配条件是round.round_id == flight.id,而flight.id是每个 peer 各自递增的_rpc_sequence;三节点一次广播通常只有一个 Follower 可能对上 round,且新读仍可能挂到已发出的 round 上。“只用请求之前产生的旧 ACK 就通过读屏障”不能视为已关闭。F6 仍未关闭:readindex_tests自实现ReadIndexManager不链接生产RaftNode;connection_order_tests主要打印说明,CTest 仍计为通过。CI 只跑RAFTKV_BUILD_SERVER=OFF可移植目标与*_tests.py。 - 取舍与未完成事项:默认
--linearizable_reads=false,未开开关时 GET 仍是本地读。README 已把 ReadIndex 标为完成;仓库内read-consistency.md与review-status.md仍写“线性一致读未实现”,文档与代码不一致。本条保留检查当时的结论。F1 的 round / rpc 直接比较由同日更晚的75bee54关闭,F6 的生产回归和 Linux 三节点 CI 记在 2026-09-23 条目。 - 关联提交、报告与原始证据:检查基线
831a91c、P1 修补60ddf84、P2 修补673fbb6、架构检查报告、当时 HEADcb1b3f8。本轮无新的分区 / 崩溃 / 过载原始证据包。
2026-09-21 / 09-22|ReadIndex 线性一致读:默认关闭,未做 Linux 证据归档
- 问题或目标:为可选强一致读提供读屏障:多数派确认当前 Leader 后,等待本地应用到读索引再返回 GET。
- 本次改动:新增
--linearizable_reads(默认 false)。Leader 在本任期 no-op 提交后记录当时commit_index作为读屏障,向 peer 发空 AppendEntries,多数派确认且lastApplied >= read_index后再读本地 KV;超时 1000 ms,队列深度上限 10000;卸任时拒绝未完成读;INFO 增加read_index_*计数。Server 层 GET 走RequestReadIndex回调,连接用weak_ptr,并与每连接命令队列串行衔接。实现中曾修过心跳 ack 只计入最后一个 round 的错误(1c71092),后被 09-22 架构检查再次指出关联标识不足。 - 验证环境与方法:可移植单测与若干 Python 辅助脚本被报告通过;
readindex_tests不覆盖生产RaftNode。仓库内benchmark-results/benchmark-summary.json给出混合 / 读多 / 纯读吞吐,是不同读写比例下的吞吐,不是 ReadIndex 相对本地读的对照,也没有 09-13 那种源码/二进制指纹与核验脚本。 - 实测结果:不填写性能提升比例。隔离旧 Leader 不得返回过期强一致读这一验收场景,没有对应的已核验 Linux 证据包。
- 取舍与未完成事项:未改写路径的同步落盘、多数派提交或去重语义;当时没有快照、Pre-Vote/CheckQuorum。默认关闭开关,避免把未完成验收的路径当成默认语义。快照、IDEMP 和租约读见 2026-09-28 条目,Pre-Vote 与 CheckQuorum 见 2026-09-23 条目。
- 关联提交、报告与原始证据:心跳 round 修补
1c71092、合并后 HEADcb1b3f8、仓库更新日志。无已核验的 ReadIndex Linux 证据包。
2026-09-21|每连接命令队列:保证同连接读写顺序
- 问题或目标:同一 TCP 连接上 GET/PING 原先立即执行,SET/DEL 经 Raft 异步完成;pipeline 下后发的 GET 可能先于前面的 SET 提交而读到旧值,回复顺序也可能与请求顺序不一致。
- 本次改动:每个
ClientSession增加 FIFOcommand_queue与executing标志;读立即执行,写提交后由完成回调驱动下一条。09-22 起非法命令也入同一队列。 - 验证环境与方法:新增
tests/test_connection_queue.py等辅助用例。connection_order_tests.cpp不能当作生产调度器回归。真实 Linux 三节点未为该改动单独归档。 - 实测结果:未单独测量由此带来的延迟变化,不宣称吞吐收益。
- 取舍与未完成事项:多连接之间仍并发;单连接变为串行。队列深度与内存上限见同日架构修补条目。
- 关联提交、报告与原始证据:见仓库 CHANGELOG 与相关 PR;无单独 Linux 证据包。
2026-09-21|存储健康追踪、协议注释与复制边界测试
- 问题或目标:存储异常时避免把失败伪装成成功或不存在;补充协议注释与可测的复制边界模型。
- 本次改动:RaftNode 增加
_storage_healthy。Leader/Follower 日志追加与状态机应用捕获存储异常后置为不健康并重新抛出(fail-stop);不健康时Propose返回-3,拒绝新提案。节点状态转换补了 Raft §5.1–§5.4 注释;新增replication_partition_tests.cpp、replication_edge_cases_unit.cpp等独立逻辑测试;同步整理审阅文档、构建目录约定和测试说明。 - 验证环境与方法:新增
tests/storage_failure_tests.cpp,用 RocksDB 测试替身注入写失败,覆盖 Leader/Follower 追加与单节点应用失败。这证明调用顺序与健康标志,不证明真实磁盘损坏或掉电。复制边界测试是模型/追踪器示例或分区编排的可测部分,不能替代生产RaftNode在真实 TCP 上的行为。 - 实测结果:无行为对比实验,不填写性能数字。
- 取舍与未完成事项:fail-stop 拒绝新提案,而不是降级继续服务;真实存储故障与整机掉电仍待专项验证。
- 关联提交、报告与原始证据:见仓库 CHANGELOG;无新的 Linux 故障证据包。
2026-09-16|许可证、可移植 CI 与日志尾缓存
- 问题或目标:补齐项目许可证说明,让可移植回归可在 GitHub Actions 自动跑,并减少日志尾 term 的反复读盘。
- 本次改动:根目录增加 MIT
LICENSE与NOTICE,README 补充来源与改造范围说明。新增 GitHub Actionsportable.yml:RAFTKV_BUILD_SERVER=OFF构建可移植 C++ 回归并运行tests/*_tests.py。Raft 日志在扫描和追加后缓存尾部 term;storage_batch_tests增加对应检查。文档改为以可复现构建、故障证据和项目实践长文为主;去掉未跟踪的捆绑依赖。 - 验证环境与方法:CI 仍不构建真实 Muduo/RocksDB 服务,也不跑三节点故障脚本。日志尾缓存无独立吞吐对照。
- 实测结果:不填写性能提升比例。
- 取舍与未完成事项:可移植 CI 不能替代真实三节点 Linux 服务与故障脚本;完整 Linux CI 仍在路线图中。
- 关联提交、报告与原始证据:见仓库 CHANGELOG 与
.github/workflows/portable.yml;无新的集群故障证据包。
2026-09-13|客户端头部读取对照完成:保留 classic 默认
- 问题或目标:检验合并 RESP 回复类型字节与头部行读取,是否降低客户端 CPU 成本并改善同机吞吐。
- 本次改动:增加可选
combined-header模式与 classic → combined-header → combined-header → classic 四轮驱动;服务端二进制不变,继续使用同一测量窗口和跨轮核验口径。 - 验证环境与方法:双核 Ubuntu VM,三节点与客户端同机;每轮 32 连接、pipeline=1、128 字节 value、读写各半,预热 10,000 次、正式 100,000 次;本地相关辅助检查 16/16 PASS。
- 实测结果:四轮 400,000 次正式请求零错误;classic / combined-header 合并吞吐 6705.69 / 6602.85 次/秒,客户端 CPU 成本 113.7 / 121.8 微秒/次;每轮结束后三副本收敛、队列清零。
- 取舍与未完成事项:本轮未观察到收益,保留 classic 默认。同模式轮间波动明显,不认定合并模式普遍更慢;未取得函数级热点或独立客户端实验结果。
- 关联提交、报告与原始证据:实现及对照驱动
653cc14、归档提交051ca62、对照报告、原始证据包。
2026-09-13|正常负载诊断完成:补齐 CPU 与阶段差分
- 问题或目标:了解正常读写时客户端、服务节点与整机 CPU 的分布,用同一正式窗口核对阶段计数。
- 本次改动:9 月 9 日发布独立负载进程与测量边界回调,9 月 13 日完成原始证据验收归档;增加 CPU 采样、阶段差分、源码和构建身份检查,没有修改服务端持久化语义。
- 验证环境与方法:双核 Ubuntu VM,同机三个节点及 Python 客户端;预热 10,000 次、正式 100,000 次;正式窗口内采样 38 条,33 个编译/测试输入与测试提交匹配。
- 实测结果:100,000 次请求零错误,成功吞吐 5145.92 次/秒,P99 21.663 毫秒;客户端约占单核 62.88%,整机平均 CPU 空闲 4.97%;正式写入计数差分为 50,000,副本检查与收敛通过。
- 取舍与未完成事项:该轮是诊断基线,不作为重连优化 QPS 收益;CPU 余量小但没有函数级热点证据,阶段平均耗时不能相加为端到端延迟。
- 关联提交、报告与原始证据:诊断实现
74880f3、归档相关提交653cc14、诊断报告、原始证据包。
2026-09-09|重连退避优化完成:归档分区前后结果
- 问题或目标:分区转发器接受连接后立即关闭,触发反复重连和大量日志。
- 本次改动:每 peer 独立使用 500 / 1000 / 2000 毫秒退避,连接保持 10 秒后重置;补齐代际、生命周期与重复启动保护。
- 验证环境与方法:Windows CTest 6/6、分区辅助检查 8/8;真实 Linux 构建、CTest 7/7、三节点冒烟 10 项、分区 5 个阶段均通过;比较两轮同类分区场景的转发器计数和完整日志文件。
- 实测结果:拒绝重连 24,731 → 11;完整节点日志 5,498,325 → 146,110 字节;原有故障安全性与恢复检查通过。
- 取舍与未完成事项:退避可能增加恢复等待,初始 Leader 和选举时序不同;未测正常业务 QPS、CPU 或长期资源收益。
- 关联提交、报告与原始证据:实现
ef17ef7、归档提交44509fb、重连报告、原始证据包。
2026-09-09|分区、持续写入重启与过载测试完成
- 问题或目标:将基础冒烟扩展到失去多数派、持续写入中 Leader 退出、积压拒绝与恢复后的状态检查。
- 本次改动:增加受控 TCP 分区、持续写入请求账本、过载和短时运行脚本,保留配置、INFO、节点日志及构建身份。
- 验证环境与方法:既有 Ubuntu VM 的真实三节点服务;分区 5 个阶段、写入重启 5 个阶段、过载 4 个阶段,分别使用各自的负载与核验规则。
- 实测结果:三组均 PASS;无多数派时没有新写入成功确认;1,704 个已确认键在两次恢复后的三个副本中保留;指定连接及写入阈值触发拒绝,恢复后积压清零,约 60 秒资源观察通过。
- 取舍与未完成事项:当时仍观察到重连开销,后续由独立优化处理。三组通过不证明整机掉电安全、长期无泄漏或生产可用;全体节点退出发生在停止持续写入之后。
- 关联提交、报告与原始证据:分区测试
9cfcfd6、写入重启测试07a6127、过载测试b00e221、收尾归档b654d3d、分区报告、写入重启报告、过载报告。三份报告均链接各自原始压缩包和核验输出。
2026-09-08|Linux 自动构建与空目录全量构建验证完成
- 问题或目标:把 VM 上依赖准备与兼容修补固化为脚本,并区分增量构建检查和真正的重新编译。
- 本次改动:固定 Muduo 源码包及已核对修补,使用私有依赖安装目录,记录源码输入、构建命令与测试时二进制指纹。
- 验证环境与方法:已有系统依赖的 Ubuntu 26.04 VM,先运行增量流程,再使用新建的空构建目录执行同一自动流程、CTest 与真实三节点冒烟。
- 实测结果:两轮 CTest 均为 5/5、冒烟均为 10 项 PASS;空目录轮有 Muduo、服务与测试实际编译/链接记录,48 个已跟踪输入匹配
35a348d,15 个命令步骤依次退出 0。 - 取舍与未完成事项:空构建目录不等于干净操作系统,原始包也未包含服务二进制本体。干净系统依赖安装复现、Docker 构建与 Linux CI 仍待完成。
- 关联提交、报告与原始证据:自动流程
35a348d、归档相关提交9cfcfd6、增量流程报告、空目录全量构建报告。报告内保留原始包、指纹与复核入口。
十二、项目入口与参考资料
项目与版本入口
| 入口 | 用途 |
|---|---|
| GitHub 仓库 | 查看项目当前状态;默认分支内容可能继续更新 |
| 本文完整归档版本 | 固定本文对应的代码与报告集合 |
| 改造基线及基线 README | 界定可追溯改造起点;不替代更早来源说明 |
| 完整提交差异 | 核对实际修改范围 |
| 持续更新的 CHANGELOG | 查看本文归档之后的更新 |
| 归档 CHANGELOG | 对照本文所依据的历史更新记录 |
最初参考的教程与部分代码来源仍待找回,目前没有可确认的原教程链接可列出。Muduo、RocksDB、Protobuf 等组件的官方入口是技术参考与致谢,不替代项目早期代码出处。
关键实现入口
以下源码链接固定到本文归档版本。
| 模块 | 源码入口 |
|---|---|
| 接入、命令处理与 INFO | src/server/main.cpp |
| RESP 解析与未消费输入 | src/common/resp_parser.h、src/common/command_buffer.h |
| 选举、复制、提交与应用调度 | src/raft/raft_node.cc |
| 节点间连接管理 | src/raft/peer_manager.cc |
| 重连退避策略 | src/common/peer_retry_policy.h |
| Raft 日志持久化 | src/raftcore/raft_log.cc |
| KV 状态机 | src/raft/kv_state_machine.cc |
| 串行异步执行器 | src/raft/serial_apply_executor.cc |
| RocksDB 存储封装 | src/storage/rocksdb_store.cpp |
构建与实验资料
当前构建操作优先阅读持续维护的Linux 构建说明与测试说明。复核本文则使用下表固定版本的资料。
| 资料 | 支撑的内容 |
|---|---|
| 归档构建说明与归档测试说明 | 对应版本的依赖、编译、运行及测试方法 |
| Linux 自动流程验证 | 增量流程与运行时身份记录 |
| 空目录全量构建验证 | 既有 VM 上重新编译、链接及测试的记录 |
| 网络分区验证 | 少数派隔离、多数派继续写入与恢复收敛 |
| 持续写入与重启验证 | Leader 退出及重启后已确认写入的保留 |
| 过载与短时持续运行验证 | 准入、BUSY、积压释放和有限资源观察 |
| 重连退避优化实测 | 拒绝重连次数与日志量的前后比较 |
| 正常读写性能诊断 | 客户端、节点 CPU 及各阶段耗时 |
| 客户端头部读取 ABBA 对照 | 未观察到收益的实验与保留默认实现的决定 |
| 较早的同步/异步 ABBA 基线 | 早期独立实验的完整结果与身份限制 |
| 原始证据目录 | 各实验压缩包、文件指纹与核验输出 |
各报告内的 verify_*.py 链接给出只读复核程序。例如,在保留相关 Git 历史与证据包的仓库根目录,可以执行:
python docs/benchmarks/verify_reconnect_validation.py
python docs/benchmarks/verify_client_header_validation.py
它们检查已归档证据,不启动服务,也不重新进行性能实验。完整 JSON 和节点日志位于对应原始压缩包中;复核 PASS 表示所检查的材料与规则一致,不等于性能改善或覆盖所有故障场景。
理论与技术参考
| 资料 | 在本文中的用途 |
|---|---|
| Raft 官方资料入口 | 算法介绍、论文与可视化资料 |
| Raft 论文:In Search of an Understandable Consensus Algorithm | 第 5 节对应选举与复制,第 7 节对应日志压缩,第 8 节对应客户端交互与只读请求 |
| Muduo 官方仓库 | 事件循环、TCP 连接管理与线程模型 |
| RocksDB Basic Operations | 基本读写、WriteBatch 与同步写入选项 |
| Protocol Buffers 官方文档 | 节点间消息定义与序列化 |
| Redis RESP 协议规范 | 命令编码、回复格式、长度字段和分片解析 |
| etcd API 一致性保证 | 对照理解线性一致性、本地读取和失败请求的语义边界 |
项目还使用 gflags 处理命令行参数,使用 glog 记录运行日志。感谢这些项目及其维护者提供基础组件与公开资料;引用它们不代表 Raft-KV 具备这些成熟系统的完整能力。