SearchPilot 项目介绍:把搜索、排序与实验证据连起来
2026-10-27
本文整理于 2026-10-27,依据已合并版本 5644ce4。多步 Agent 已随 PR #57 合并;长时间内存稳定性仍在单独验证,本文只引用已归档的完整实验。项目 README提供运行入口。
阅读路线:整体结构 → 数据与标注 → 召回与排序 → 推荐与 CTR → 多步 Agent → 工程问题 → 实验结果。
一、项目解决什么问题
一个检索算法输出 Top-K,只完成了搜索系统的一部分。系统还需要回答:数据来自哪个版本,关键词和语义召回怎样合并,排序模型用了哪些特征,缺少索引时如何响应,以及某次实验能否与另一组数字直接比较。SearchPilot 将这些问题放在同一条可追溯链路中。
项目以 MIND Small 新闻数据为基础。搜索侧比较 BM25、向量、RRF 和 LTR;推荐侧为有历史与无历史用户提供不同回退;广告侧展示点击概率校准如何影响带出价排序;实验侧保存配置、指标、分组和失败样例。Agent 则使用这些登记信息回答问题,不直接操作数据库或修改模型。
二、整体结构与一次请求
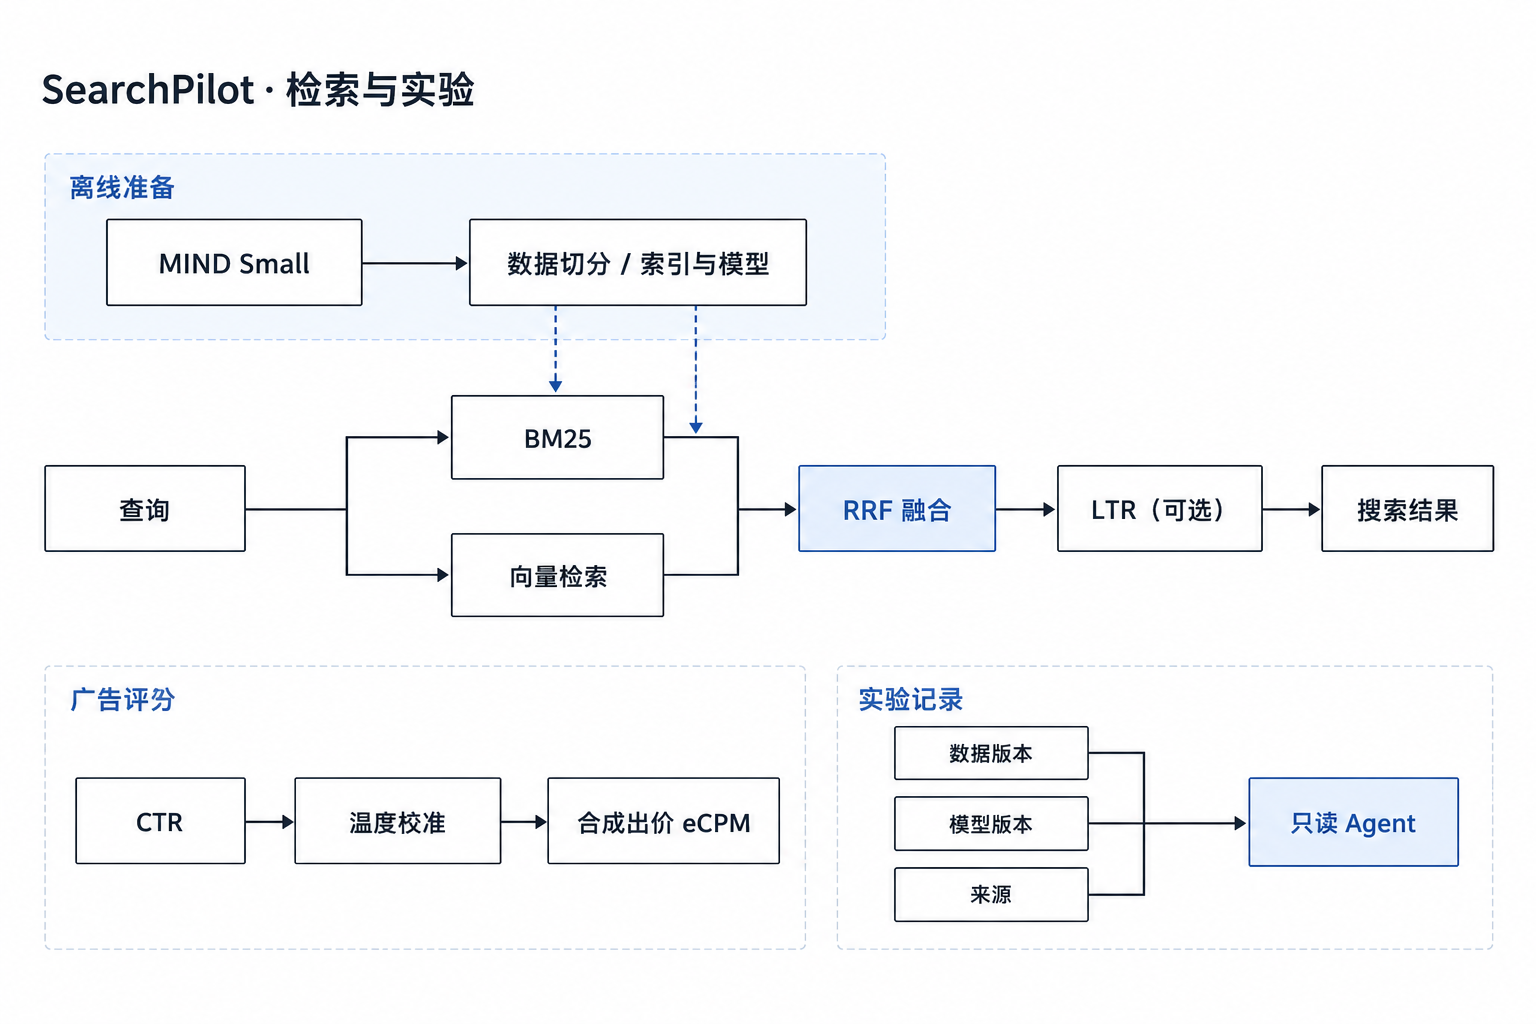
离线脚本生成 Parquet 数据快照、索引、模型和评估报告。在线应用通过 bootstrap.py 装配搜索、推荐、CTR、反馈与实验仓储;ports.py 定义模块间协议,Pydantic 模型定义 HTTP 输入输出。算法实现与 API 路由分开,使测试可以注入小语料或内存仓储,真实运行则加载固定产物与 PostgreSQL。
| 入口 | 实际行为 | 关键输出或边界 |
|---|---|---|
| POST /search | 选择 bm25、vector、hybrid 或 ltr,可按类别过滤 | 返回排名、分数、通道与模型版本 |
| POST /recommend | 已有历史走 ItemCF,无历史走热门回退 | 返回推荐通道与 cold_start |
| POST /ctr/score | 加载 CTR 模型和校准器计算点击概率 | 模型未就绪返回 503 |
| POST /feedback | 按幂等键保存曝光或反馈 | 同键同内容重放,同键不同内容冲突 |
| GET /experiments/{id} | 读取实验配置、指标和来源 | 保留数据、协议与代码版本 |
| POST /agent/analyze | 确定性分析或显式开启的多步 LLM 模式 | 返回状态、停止原因、动作轨迹和引用 |
例如一次 mode=hybrid 的请求,经过输入校验、查询归一化、两路候选召回、去重融合后返回结果。索引缺失和“合法查询没有命中”是两种不同状态:前者返回 503 NOT_READY,后者才是有效空结果。/health/live 检查进程,/health/ready 检查依赖;流量准入不能只看进程存活。实现见搜索服务。
三、数据、标注与版本如何对应
归档数据版本为 d3a904f41240,包含 65,238 条物品。搜索查询集共 100 条,按固定种子切为 70/15/15;相关性使用 0–3 级标注,并保存标注者身份。CTR 的曝光数据另有时间切分,因此搜索查询测试集和点击率测试集不是同一个分母。
原始双标、补充候选池标注、争议裁定与正式评估入口分别保存。原始 labels.csv 不被诊断性补标覆盖,train/val 裁定也不会悄悄改变 test。这个划分很关键:如果大量标注文档来自 BM25 前列,未标注的向量候选直接按 0 分处理,就可能把候选池偏差混入模型比较。
项目因此同时保留原口径、补充候选池后的口径和“仅评价已标注文档”的诊断,逐条追踪不同口径造成的变化。它们用于解释差异,不能挑选对某个模型最有利的一张表当作统一成绩。数据快照、模型元数据和实验记录共同保存版本与来源,原始数据及大型模型产物需要按文档重新准备。见候选池标注诊断与分歧裁定记录。
四、从两路召回到可解释排序
BM25、向量与 RRF
BM25 使用归一化与词干处理后的词项查询倒排索引,适合实体名和明确词面条件;向量路径使用 BAAI/bge-small-en-v1.5 编码查询,并做精确余弦检索,提供词面之外的候选。混合模式分别取两路 Top-100,再通过 RRF 融合。融合看名次而非直接相加原始分数,避免把 BM25 分值与余弦相似度当作同一尺度。
RRF(d) = Σ 1 / (60 + rank_i(d))
同一通道的重复文档只计一次;融合去重后按分数排序。
分数相同时按 item_id 排序,保证结果可复现。
默认融合参数为 60。某一路没有召回的文档不会在该路获得名次贡献。项目也保留分数归一化融合用于对照,但默认使用 RRF。实现见融合函数。
LTR 怎样训练,为什么没有带来提升
LTR 是线性 pairwise 模型。对同一查询下等级不同的文档组成高低相关性对,优化 softplus(-(s_hi - s_lo)),让高相关文档的分数更大。训练和在线推理共用候选与特征组装路径;训练只使用 train 标签,均值和标准差用于特征标准化。
| 特征组 | 具体特征 |
|---|---|
| 召回信号 | BM25 分数、向量分数、BM25 名次、向量名次 |
| 统计与时间 | 训练点击数的 log1p、freshness_days |
| 内容 | 类别匹配、标题字符数 |
两路 Top-100 的并集进入候选处理。文档未进入某一路前 100 时,名次特征记为 101,但仍补算该路的精确分数。这个缺席值是后来诊断的关键:已保存模型给 bm25_rank 学到了约 +0.635 的权重,导致名次数字越大反而贡献越高,缺席候选可能被抬到高相关文档前面。
训练使用 70 条查询、705 行标注形成的 974 个文档对,40 个 epoch 后训练损失从 1.107 降至 0.183,但 test 排序仍退步。将缺席名次替换为训练均值没有消除问题;进一步将名次权重置零是诊断消融,并未成为重新验收的新模型。这里保留了从候选覆盖、特征语义到权重方向的分析链路。见LTR 实现与名次特征消融。
五、回退推荐、CTR 校准与广告评分
推荐接口独立于搜索。已有历史用户可通过 ItemCF 利用物品共现取得邻居,无历史用户走热门回退。项目曾在启动阶段构建完整共现图,再展开双向邻居表,最后只保留每件物品的前 50 个邻居;中间图的内存成本远大于最终模型。
改进后的拟合先建立“物品 → 去重用户历史”的倒排表,再逐物品统计共现并保留 Top-K,完成一行即释放临时统计。配对计算量仍为 O(Σ h²),主要减少完整共现图的中间空间。5,000 用户的 A–B–B–A 对照中,完整邻居及 Top-10 预测的规范 JSON 指纹一致,拟合均值 3.265 → 2.094 秒,进程生命周期峰值工作集约下降 61.8%。这是固定子集两轮对照;完整 50,000 用户只运行了新版本,不据此报告全量加速比。见ItemCF 对照。
CTR 路径使用用户历史长度、类别匹配率、训练物品点击数和标题长度四类特征。历史归档按 200,000/50,000/50,000 行训练、验证、测试,校准器只在验证集拟合。温度缩放作用于 logit,目标是让预测概率更接近实际频率,而不是改变单独按 pCTR 排序的顺序。
| test 模型 | AUC | LogLoss | ECE |
|---|---|---|---|
| MLP 原始输出 | 0.4836 | 0.3519 | 0.0374 |
| MLP + 温度缩放 | 0.4836 | 0.1673 | 0.0063 |
校准降低了概率误差,但 AUC 没有变化,且这组 AUC 不支持“点击区分能力优秀”的结论。正历史用户、零历史用户、冷物品与已有点击物品还要分别检查。当前实验没有位置特征,日志中的位置偏差也是限制。完整 LR、Platt、等渗回归对照见CTR 报告。
广告演示按 合成 bid × pCTR 比较 eCPM 排序。校准对概率是单调变换,但不同物品再乘不同出价后,排名可以变化:20,831 次曝光的对照中,Top-1 一致率为 0.9180。出价来自固定种子的合成映射,没有真实竞价、预算 pacing 或 CVR 链路,因此代理收入只能用于这组实验内比较。见合成出价实验。
六、反馈与实验登记怎样保持可追溯
反馈记录携带请求、物品、事件时间、模型版本及幂等键。PostgreSQL 使用唯一键和 INSERT ... ON CONFLICT DO NOTHING 处理重复提交;插入未发生时读取已有内容摘要。同键同内容返回原事件,同键不同内容返回 409。这样网络重试不会增加一条重复反馈,也不会静默覆盖第一次提交。内存实现采用同样的载荷摘要规则,但只有数据库路径能跨进程重启保留。
实验登记除总体指标外,还保存配置、数据版本、代码提交、协议、source 与 source_ref。比较函数发现来源或协议不同就返回不可比较,不生成提升结论;同源同协议也仍需查看切分与实验条件。登记信息是 Agent 查询的对象,不能把“有一条实验记录”理解成已经重新运行了那次实验。见反馈仓储与实验登记与比较。
七、只读 Agent 如何完成多步分析
早期线上路径按规则选择工具,历史外部评测固定为“选一个工具 → 执行 → 生成答案”。2026-10-27 的版本增加了真正的执行循环:模型提出公开计划与一个动作,服务端校验参数并调用工具,再把观察交回模型,由模型决定修订计划、继续读取或结束。默认配置仍不发送模型请求,LLM 模式需要显式启用。
| 只读工具 | 用途 |
|---|---|
| list_experiments | 先发现实际存在的实验 ID |
| get_experiment_config | 读取配置、数据版本和协议 |
| get_metric | 读取指定切分的一个指标 |
| compare_experiments | 检查来源与协议并比较记录 |
| get_segment_metrics | 查看用户或物品分组结果 |
| get_failure_samples | 读取具体失败样例 |
例如“比较当前两个检索实验并解释差异”,请求不必提供实验 ID。Agent 可以先列出实验,再读取配置和指标;遇到不存在的来源或缺失指标时,在剩余步数内修正动作。若两组记录来源不同,系统返回不可比较。工具集合不包含任意 SQL、Shell 或任意网络访问,也不提供修改索引和模型的能力。
最终答案由服务端根据已验证引用和工具摘要生成。这样做来自一个具体漏洞:即使模型引用了正确记录,也可能在引用旁写出未经证据支持的数字。当前让模型负责选取证据和结束时机,把可展示的事实交给程序验证;它保留了分析动作的灵活性,也限制了自由文本解释的范围。元数据中的 ID、split、segment 还经过字符与长度校验,避免括号等内容混入引用格式。
默认每次最多 8 次模型请求、每次预留 2,048 个输出 token、总预留 16,384 个输出 token;总执行时间 90 秒,单次 HTTP 30 秒,单次工具读取 5 秒。输入 token 不在这个输出额度内,因此不能把它当作金额上限。每个应用实例最多并行两个 Agent 请求,模型或 HTTP 错误终止本轮,不自动重试;动作格式和可恢复工具错误可在原预算内纠正。没有跨请求记忆或后台自主任务。完整契约见多步 Agent 说明。
八、三个工程问题及其处理
共享词干器的并发污染
四线程诊断触发 Snowball IndexError,进一步发现 stemWords() 共享可变词干器的 current 与游标状态。一个请求执行过程中,另一个请求会改写它们,GIL 并不让整个词干化操作自动成为原子操作。修复只对共享实例的调用加锁,并通过主动让出线程放大交错来回归;数字与缩写等不走词干化的分支不受影响。没有通过更换算法或模型掩盖问题。见并发故障报告。
把首次编码成本移到启动阶段
首次向量请求需要加载和初始化模型,旧路径把这个成本留给用户请求。容器默认在监听前预热;四轮真实 HTTP 对照中,首次向量请求均值 8.817 → 0.068 秒,启动到 ready 则从 24.024 → 34.444 秒。它改善的是首个请求体验,代价是更长启动等待,没有证明总冷启动变快。预热失败时保留 BM25,向量相关模式仍明确未就绪。见启动预热对照。
区分活跃分配、分配器保留与 RSS
长时间压测发现 RSS 持续上升,诊断分别记录 API 进程、容器 cgroup 和客户端,而非只看 Docker 的一个显示值。组件层 gc.collect() 未使 RSS 降低,malloc_trim() 能释放一部分内存,说明分配器保留有贡献;这不等于所有增长均已归因。
后续 THP 与 glibc arena 对照支持将正常容器配置为进程关闭 THP、MALLOC_ARENA_MAX=2,未加入定时 GC/trim。正式负载使用正常服务入口,并记录模型、数据、镜像与结果指纹,以检查配置变化是否影响业务输出。更长观察仍是独立工作。见内存对照报告。
九、效果结果与多步任务结果
搜索 test 共 15 条查询,其中一条没有相关文档,nDCG、MRR、Recall 的有效分母为 14。以下来自同一次固定比较,不混用补标后的诊断口径。原始排序报告保留模型版本和训练条件。
| 搜索模式 | nDCG@10 | MRR@10 | Recall@50 |
|---|---|---|---|
| BM25 | 0.6396 | 0.7143 | 0.7500 |
| 向量 | 0.7769 | 0.8095 | 0.9452 |
| RRF | 0.7214 | 0.7679 | 1.0000 |
| LTR | 0.4596 | 0.4595 | 0.7175 |
RRF 的候选覆盖与向量的前列排序表现不同;LTR 在该协议下是负结果。小规模、模型标注的查询集只能支持当前诊断,不能外推线上搜索质量。
新 Agent 另用八个公开合成任务验证未知 ID 发现、工具错误后的改计划、跨来源比较拒绝与配置注入,每类有两个 ID/数值变体。最终运行时 8/8 正常结束,原结构化评分为 6/8。两个失败来自评分器要求“第一次工具调用即发现成功”;实际任务允许列表参数出错后纠正,只要求依赖 ID 的读取发生在成功发现之后。
修正评分器后,对同一批轨迹事后复算为 8/8,新增模型调用为 0,原始 6/8 与 FAIL 保留。这个结果不是新一轮预注册实测。开发各轮、独立诊断与两次 API 验证合计 120 次外部请求、129,842 个已知 token;容器真实 HTTP 路径也已验证,但只启动 Agent 与本地登记,不能代替整站验收。历史两阶段 46/50 与新八题成绩分别报告,不能互相覆盖。见完整多步验证报告。
十、负载覆盖与当前交付边界
| 并发 | 正式时长 | 成功请求 |
|---|---|---|
| 4 | 15 分钟 | 9,358 / 9,358 |
| 16 | 15 分钟 | 12,538 / 12,538 |
| 32 | 60 分钟 | 53,309 / 53,309 |
2026-10-25 这组实验覆盖 1,300 条查询与四种模式,5,200 组结果指纹跨档一致。扩展查询用于负载覆盖,不是新增 1,300 条人工相关性标注。并发 32 最后 20 分钟 RSS 增长 1.535 MiB,斜率 0.0936 MiB/分钟,通过该轮预设门槛;全小时仍增长 55.984 MiB,且有背景容器争用。因此结果只说明该次有限窗口,没有给出容量 SLA 或无限期无泄漏保证。见扩大查询容器报告。
十一、当前限制与后续方向
项目已把数据、召回、排序、服务和实验分析连起来。剩余重点是扩大并独立复核相关性标注,处理 LTR 的候选与特征问题,验证 CTR 的区分能力,并完成剩余内存增长的长期观察。多步 Agent 已有有限领域的执行机制与真实模型证据,但八个合成任务不代表通用规划能力、自然语言解释质量或生产稳定性。后续实验继续固定输入、代码与协议,使新旧结论可以明确对照。